Kubernetes — Arquitetura, Operação e Engenharia de Plataformas
Sumário do artigo
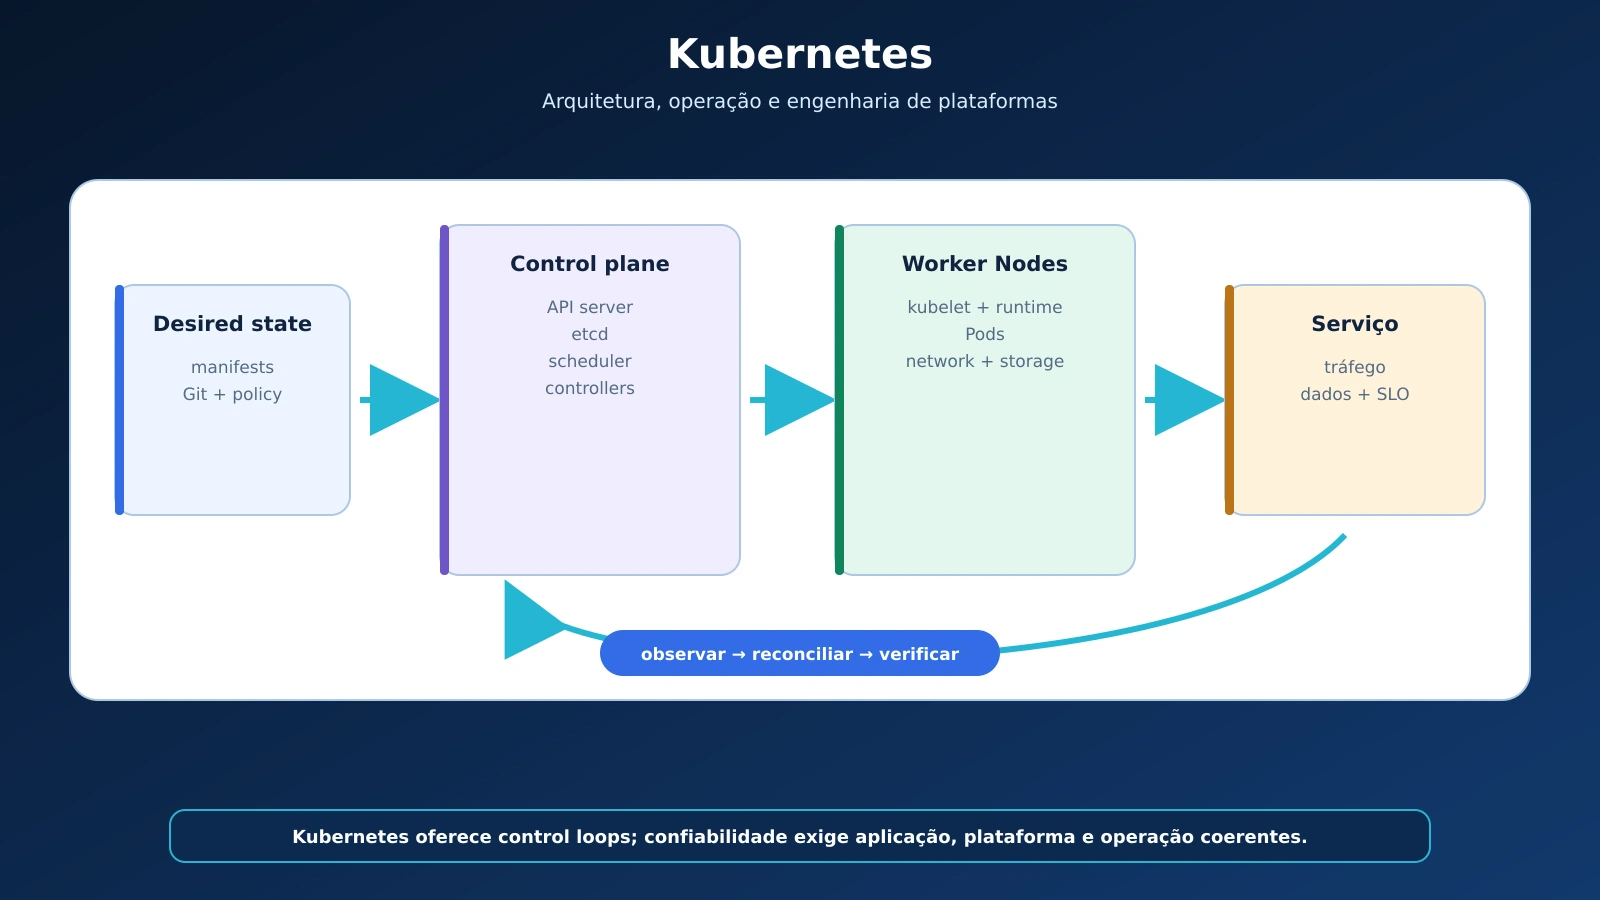
Figura 1 — Kubernetes relacionando desired state, control plane, Worker Nodes e serviço observável.
Prefácio
O roadmap fornecido organiza os principais assuntos de Kubernetes: containers, instalação, Pods, controllers, configuração, services, networking, security, resource management, observability, storage, scheduling, autoscaling, deployment patterns, extensões e operações de cluster. Como mapa, ele indica a direção. Como formação técnica, deixa perguntas essenciais sem resposta: quem reconcilia o estado, como uma requisição encontra um Pod, o que acontece durante um OOMKill, por que um Secret não é automaticamente seguro e como recuperar um cluster cujo etcd foi perdido.
Este estudo transforma o mapa em uma trajetória de engenharia. Kubernetes é tratado como um sistema distribuído orientado por APIs declarativas, não como uma coleção de comandos kubectl. Cada recurso será relacionado ao problema que resolve, à falha que pode introduzir e à evidência necessária para operá-lo.
Em 4 de setembro de 2026, a versão corrente é Kubernetes v1.37, lançada em 26 de agosto de 2026 com 67 enhancements. Recursos Alpha, Beta, GA, APIs e defaults mudam entre releases; por isso, todo manifesto crítico deve ser confrontado com a documentação correspondente à versão real do cluster [1–2].
Tese central: Kubernetes não torna uma aplicação confiável por hospedá-la. Ele fornece mecanismos para declarar, observar e reconciliar estado. Confiabilidade surge quando a aplicação, a plataforma e a operação usam esses mecanismos de forma coerente.
Como estudar este material
Use quatro perspectivas simultâneas:
- Modelo mental: API, desired state, reconciliation loop, control plane e data plane.
- Desenvolvimento: imagem, configuração, probes, recursos, rollout e observabilidade.
- Plataforma: networking, storage, security, policy, scheduling e autoscaling.
- Operação: incidentes, capacity, backup, upgrade, disaster recovery e custo.
Os exemplos usam YAML e comandos reproduzíveis, mas não devem ser aplicados diretamente em produção. Pratique em cluster local, namespace exclusivo e repositório versionado. Antes de qualquer comando, confira o contexto:
kubectl config current-context
kubectl cluster-info
kubectl auth can-i --list --namespace laboratorio
Objetivos de aprendizagem
Ao final, você deverá conseguir:
- explicar control plane, worker node e reconciliation loop;
- distinguir container, Pod, ReplicaSet, Deployment, StatefulSet, DaemonSet, Job e CronJob;
- construir manifestos com labels, selectors, resources, probes e security context;
- explicar o caminho de rede de um cliente até um container;
- escolher entre Service, Ingress e Gateway API;
- aplicar ConfigMaps, Secrets e external secret management com limites claros;
- raciocinar sobre requests, limits, QoS, scheduling, preemption e eviction;
- escolher StorageClass, PV, PVC, StatefulSet e estratégia de backup;
- implementar least privilege com RBAC, ServiceAccounts, Pod Security e NetworkPolicy;
- correlacionar Events, logs, metrics e traces durante troubleshooting;
- comparar HPA, VPA e Cluster Autoscaler;
- estruturar Helm, Kustomize, CI/CD e GitOps;
- compreender CRDs, controllers e Operator pattern;
- decidir entre cluster managed e self-managed;
- planejar upgrade, backup de
etcd, high availability e disaster recovery.
Capítulo 1 — Por que Kubernetes existe
1.1 Do container isolado ao sistema distribuído
Um container empacota processo, filesystem e dependências. Ele não decide em qual servidor deve executar, não recria a si mesmo após falha da máquina, não distribui tráfego, não atualiza várias réplicas com segurança e não mantém uma API global de estado.
Kubernetes é um sistema open source para automatizar deployment, scaling e management de aplicações em containers [1]. Seu problema central é coordenação: muitas cargas, máquinas, versões, identidades e dependências mudando ao mesmo tempo.
1.2 O que Kubernetes fornece
- API declarativa e extensível;
- scheduling de Pods em Nodes;
- controllers que reconciliam desired state;
- service discovery e abstração de endpoints;
- rollout e rollback de workloads;
- integração com networking e storage por plugins;
- primitives de configuração, identidade, policy e isolamento;
- sinais de estado para observabilidade e automação.
1.3 O que Kubernetes não fornece sozinho
Kubernetes não inclui automaticamente:
- pipeline CI/CD;
- registry privado;
- estratégia de backup da aplicação;
- banco altamente disponível;
- observability stack completa;
- secrets manager externo;
- segurança de supply chain;
- SLO, runbook e processo de incidente;
- arquitetura correta do software.
O cluster é uma plataforma de primitives. A organização compõe controllers, plugins e processos sobre essas primitives.
1.4 Quando usar
Kubernetes é coerente quando existem múltiplos serviços ou equipes, necessidade de portabilidade, automação consistente, scaling variável, workloads heterogêneos e capacidade para operar a plataforma.
1.5 Quando não usar
Uma aplicação pequena, estável e mantida por uma equipe reduzida pode ser mais simples em VM, container host, Platform as a Service ou serviço serverless. Se a equipe não consegue manter imagens, observabilidade, backup e segurança, adicionar Kubernetes aumenta failure modes antes de gerar valor.
| Alternativa | Vantagem | Limitação | Bom encaixe |
|---|---|---|---|
| VM + systemd | simples e explícita | automação manual cresce rápido | poucos serviços estáveis |
| Docker Compose | excelente ambiente local | não é scheduler de cluster | desenvolvimento e pequeno host |
| PaaS | baixo esforço operacional | menor controle e possível lock-in | produto com equipe enxuta |
| Serverless | escala e cobrança por uso | limites de runtime e arquitetura | eventos e funções curtas |
| Kubernetes managed | control plane operado pelo provider | custo e complexidade permanecem | plataforma multiworkload |
| Kubernetes self-managed | controle máximo | maior responsabilidade operacional | requisitos especiais e equipe madura |
Exercícios
- Liste três problemas que Docker sozinho não resolve em um cluster.
- Compare uma aplicação Flask única em VM e em Kubernetes.
- Identifique um cenário em que Kubernetes seria complexidade sem retorno.
Nota Zettelkasten — ZK-K8S-001
Título: Kubernetes como sistema de coordenação
Kubernetes coordena estado desejado, placement, rede, storage e lifecycle de workloads; ele não substitui arquitetura, segurança ou operação.
Capítulo 2 — Containers, imagens e runtime
2.1 Imagem não é container
Uma image é um artefato imutável composto por layers e metadata. Um container é uma execução dessa imagem com isolamento de namespaces, controle de recursos por cgroups e filesystem gravável efêmero.
O mesmo digest identifica o mesmo conteúdo. Uma tag como app:latest pode apontar para conteúdo diferente ao longo do tempo. Produção deve preferir versão imutável e, quando necessário, digest:
image: registry.example.com/portal@sha256:3a1f...c92d
2.2 OCI, CRI e runtime
- OCI padroniza formatos de image e runtime;
- CRI é a interface entre kubelet e container runtime;
- runtimes como
containerdouCRI-Ocriam containers; - Kubernetes não usa Docker Engine como requisito para Nodes modernos.
O kubelet pede ao runtime que faça pull da image e crie o sandbox do Pod. Essa separação permite trocar implementações sem alterar a API do workload.
2.3 Construção para Kubernetes
Uma boa image:
- possui base mínima e atualizada;
- executa como usuário sem privilégio;
- não contém secret;
- expõe processo em foreground;
- responde corretamente a
SIGTERM; - grava logs em
stdoutestderr; - possui Software Bill of Materials quando exigido;
- é escaneada e assinada no pipeline;
- não depende de escrita em filesystem de root.
2.4 Multi-stage build
FROM python:3.13-slim AS builder
WORKDIR /build
COPY requirements.txt .
RUN pip wheel --no-cache-dir --wheel-dir /wheels -r requirements.txt

FROM python:3.13-slim
RUN useradd --system --uid 10001 appuser
WORKDIR /app
COPY --from=builder /wheels /wheels
RUN pip install --no-cache-dir /wheels/* && rm -rf /wheels
COPY app ./app
USER 10001
CMD ["gunicorn", "--bind=0.0.0.0:8000", "app:create_app()"]
Esse exemplo reduz dependências de build na image final, mas ainda exige pinning, scan, provenance e teste.
2.5 Processo principal e graceful shutdown
Quando um Pod termina, o kubelet sinaliza o processo. Se a aplicação ignora SIGTERM, requisições podem ser interrompidas no fim do grace period. O processo PID 1 deve propagar sinais, parar de aceitar novas conexões e finalizar trabalho em andamento dentro de um limite conhecido.
Exercícios
- Explique por que tag mutável prejudica rollback e auditoria.
- Revise um Dockerfile e identifique privilégios e artefatos desnecessários.
- Desenhe um graceful shutdown para uma API com requests de até 20 segundos.
Nota Zettelkasten — ZK-K8S-002
Título: Imagem como unidade de supply chain
Uma image confiável é imutável, mínima, rastreável, testada e executável sem privilégio; o cluster não corrige uma image insegura.
Capítulo 3 — Arquitetura do cluster
3.1 Control plane e worker nodes
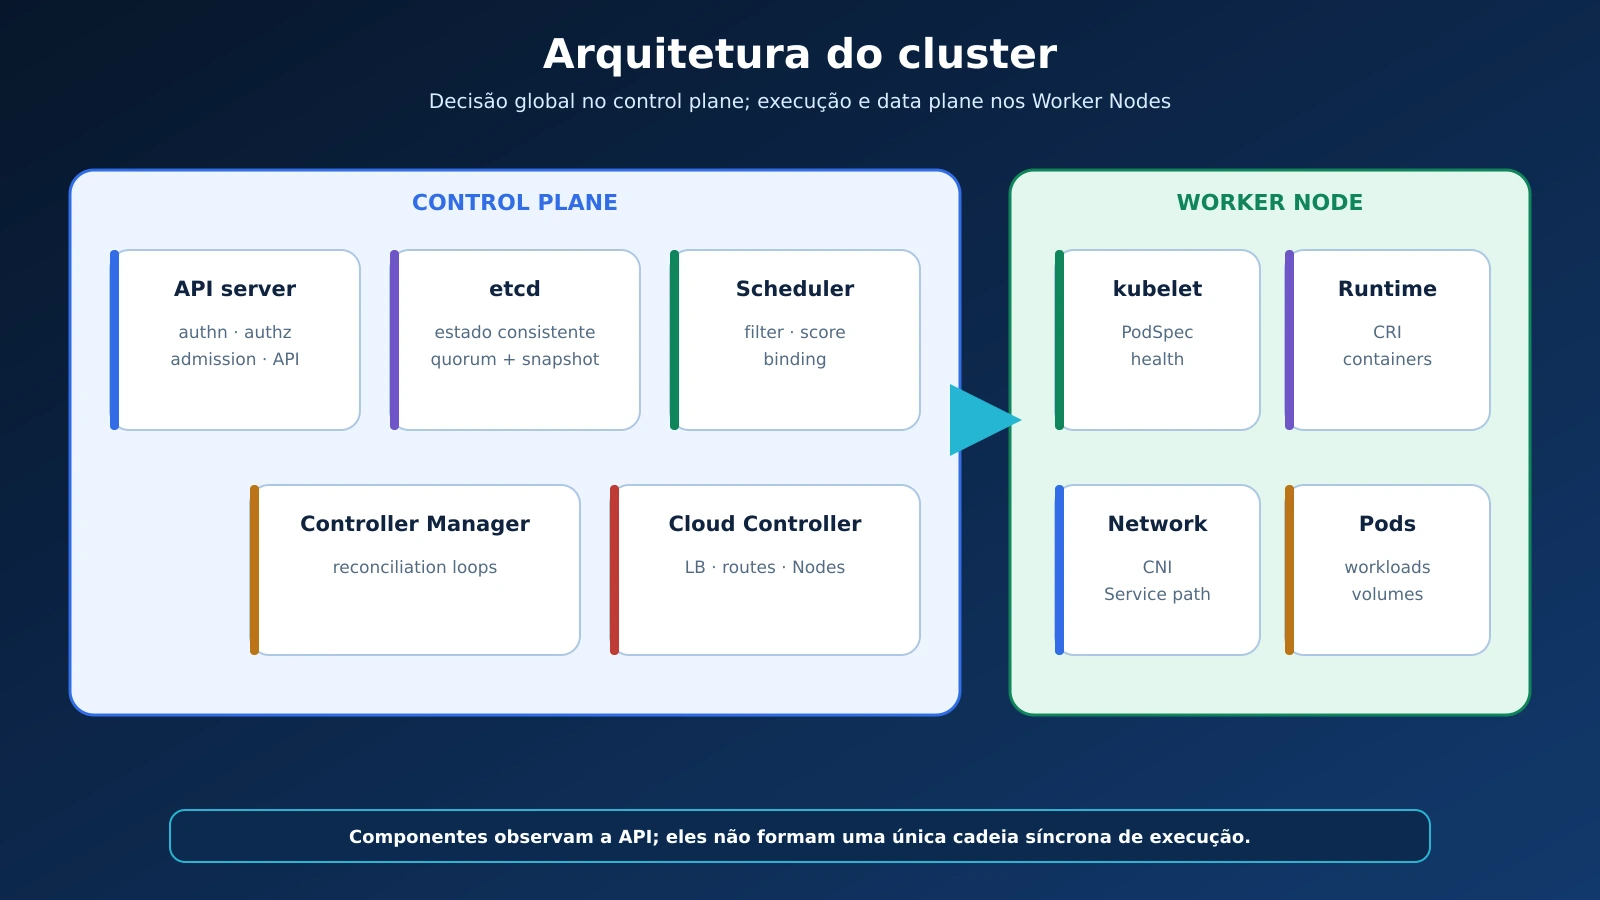
Figura 2 — Componentes do control plane e do Worker Node, com responsabilidades separadas.
O cluster separa decisão global de execução local [3]:
| Componente | Responsabilidade | Falha observável |
|---|---|---|
kube-apiserver |
valida e serve a Kubernetes API | comandos e controllers perdem acesso |
etcd |
armazena estado consistente do cluster | control plane perde sua fonte de verdade |
kube-scheduler |
seleciona Node para Pods pendentes | Pods permanecem Pending |
kube-controller-manager |
executa controllers centrais | estado deixa de convergir |
cloud-controller-manager |
integra cloud provider | LB, routes ou Nodes não reconciliam |
kubelet |
garante Pods e containers no Node | workloads locais não iniciam/atualizam |
| container runtime | executa containers via CRI | ContainerCreating ou runtime errors |
| network plugin | implementa conectividade Pod | falhas CNI e rede indisponível |
| service proxy/data plane | implementa caminho de Service | ClusterIP não alcança backends |
3.2 API server como centro
Componentes não formam uma cadeia rígida de chamadas. Eles observam objetos pela API, registram estado e reagem. O API server aplica autenticação, autorização, admission e validação antes de persistir.
3.3 etcd e quorum
etcd é um key-value store distribuído. Alta disponibilidade requer número ímpar de membros e latência previsível entre eles. Três membros toleram a perda de um; cinco toleram a perda de dois. Adicionar membros aumenta tolerância, mas também custo de consenso.
Uma forma simples de expressar o quorum é:
onde N é o total de membros e Q é o mínimo que precisa concordar. Para N = 3, Q = 2.
Backup de volumes da aplicação não substitui snapshot de etcd; snapshot de etcd não substitui backup consistente dos dados da aplicação.
3.4 Node não é Pod
Node é máquina física ou virtual registrada no cluster. Pod é unidade agendada sobre um Node. Se o Node se torna indisponível, o control plane atualiza sua condição e pode iniciar eviction dos Pods após os tempos configurados [4].
3.5 Add-ons
DNS, Metrics Server, Ingress/Gateway controller, observability agents e storage provisioners normalmente são add-ons. Eles não devem ser confundidos com todos os componentes core.
Exercícios
- Trace o que ocorre desde
kubectl applyaté o container iniciar. - Calcule o quorum para 1, 3, 5 e 7 membros de
etcd. - Explique por que um Node
Readynão prova que a aplicação está saudável.
Nota Zettelkasten — ZK-K8S-003
Título: Control plane orientado pela API
Kubernetes coordena componentes independentes por meio de objetos persistidos e observados na API; o sistema converge sem depender de uma única sequência síncrona.
Capítulo 4 — API declarativa e Reconciliation Loop
4.1 Desired state e current state
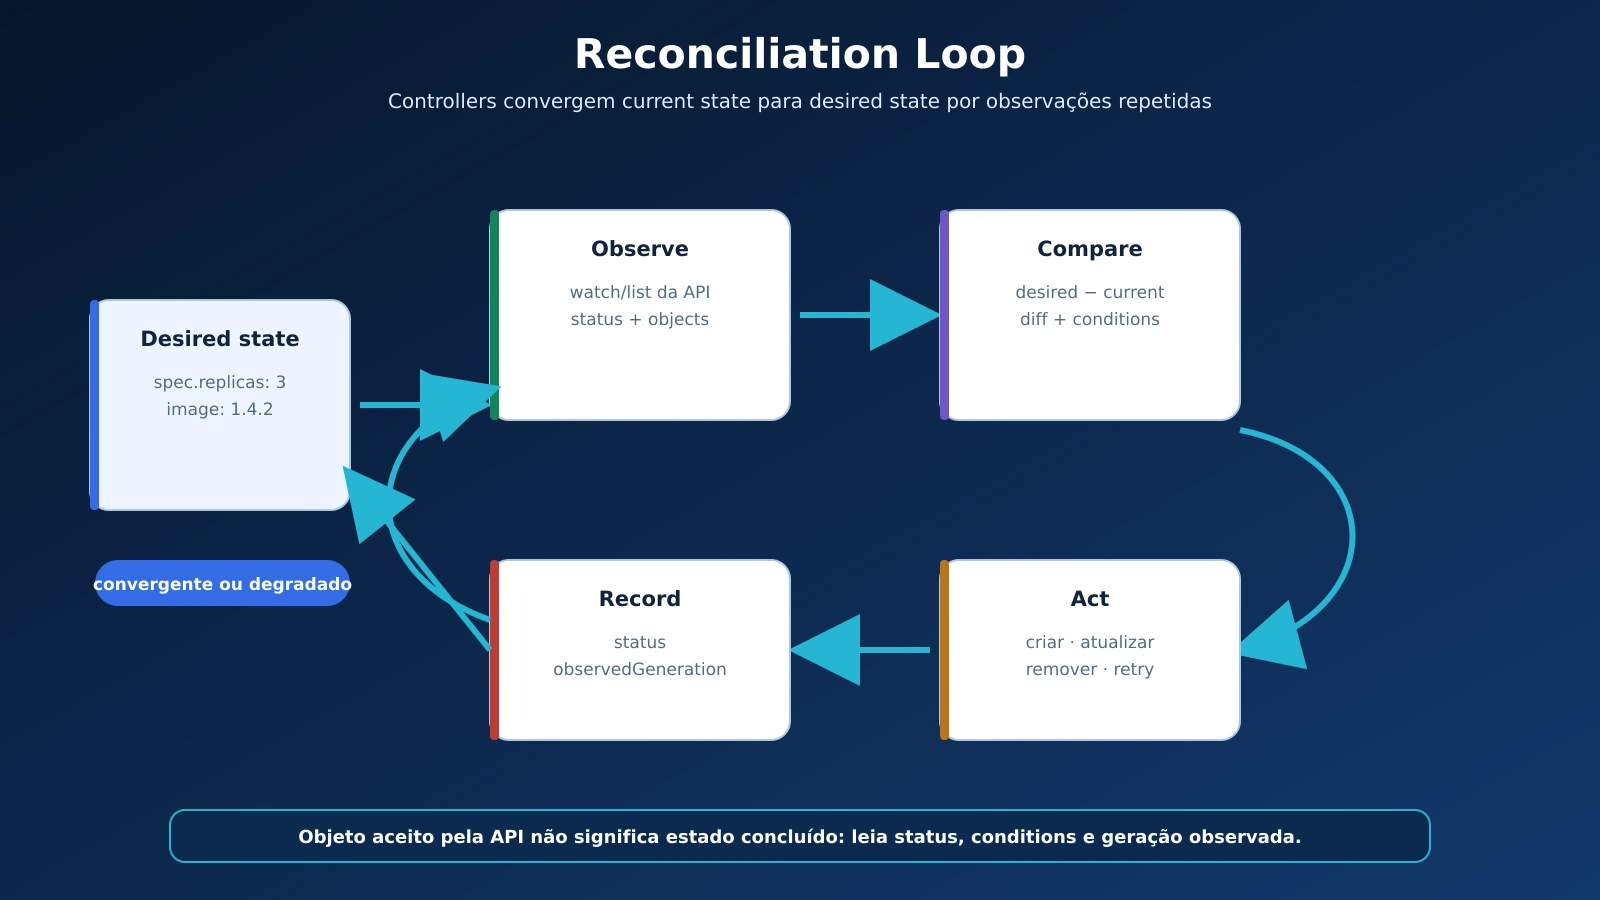
Figura 3 — Reconciliation Loop comparando desired state e current state até convergir ou registrar degradação.
Um manifesto declara intenção. O controller compara desired state e current state, executa uma ação e observa novamente. Esse Reconciliation Loop torna o sistema resiliente a falhas temporárias e mudanças concorrentes.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: portal
  namespace: laboratorio
spec:
  replicas: 3
  selector:
    matchLabels:
      app: portal
  template:
    metadata:
      labels:
        app: portal
    spec:
      containers:
        - name: web
          image: registry.example.com/portal:1.4.2
O arquivo não diz “crie Pod A, depois B”. Declara três réplicas que correspondem a um selector. O Deployment controller e o ReplicaSet controller convergem para esse resultado [5].
4.2 spec, status e metadata
metadata: identidade, namespace, labels, annotations e ownership;spec: intenção declarada;status: observação registrada por controllers;generation: versão desejada do objeto;observedGeneration: geração que o controller processou.
Um objeto existir não significa que seu estado foi aplicado. Compare conditions e observedGeneration.
4.3 Labels e selectors
Labels identificam objetos para agrupamento e seleção. Um selector incorreto pode direcionar Service ao Pod errado ou impedir controller de reconhecer seus Pods. Labels precisam de taxonomia estável, como:
labels:
  app.kubernetes.io/name: portal
  app.kubernetes.io/instance: portal-producao
  app.kubernetes.io/component: api
  app.kubernetes.io/version: "1.4.2"
Annotations armazenam metadata não seletiva: links, checksums, owner ou instruções de integração.
4.4 Ownership, garbage collection e finalizers
ownerReferences permite que dependentes sejam coletados quando o owner desaparece. finalizers adiam a remoção física até uma limpeza ser concluída. Um finalizer cujo controller não funciona deixa objeto em Terminating; remover o finalizer manualmente pode abandonar recurso externo.
4.5 Imperativo versus declarativo
Comandos imperativos são úteis para diagnóstico e laboratório. Para produção, manifests versionados oferecem review, history e reconciliação. kubectl edit em produção cria configuração difícil de reproduzir.
4.6 Server-Side Apply e field ownership
Vários controllers e ferramentas podem gerenciar campos do mesmo objeto. Server-Side Apply registra field managers e detecta conflitos. “Último YAML vence” é uma simplificação perigosa quando HPA, GitOps controller e operador escrevem no mesmo recurso.
Exercícios
- Diferencie
spec.replicas,status.replicasestatus.availableReplicas. - Explique um objeto preso em
Terminatingpor finalizer. - Crie uma taxonomia de labels para
web,workerescheduler.
Nota Zettelkasten — ZK-K8S-004
Título: Reconciliation Loop
Controllers observam estado, calculam diferença e agem até aproximar current state de desired state; status e conditions mostram a convergência real.
Capítulo 5 — Ambientes, instalação e primeira aplicação
5.1 Local, managed e self-managed
| Ambiente | Objetivo | Exemplos de responsabilidade |
|---|---|---|
| cluster local | aprendizagem, teste e CI | usuário controla ciclo curto |
| managed Kubernetes | produção com control plane operado | cliente mantém workloads, IAM, rede e dados |
| self-managed | controle integral | equipe mantém control plane, etcd, PKI e upgrades |
Kind e minikube são úteis em laboratório. Eles não simulam integralmente load balancer, storage, failure domains e IAM do ambiente produtivo.
5.2 kubeconfig e contexts
kubectl usa kubeconfig para agrupar cluster, identidade e namespace em um context [6]. Executar comando destrutivo no context errado é uma falha operacional comum.
kubectl config get-contexts
kubectl config use-context laboratorio
kubectl config set-context --current --namespace=laboratorio
Não compartilhe kubeconfig administrativo. Prefira autenticação temporária e RBAC por função.
5.3 Primeiro deployment
kubectl create namespace laboratorio
kubectl apply -f deployment.yaml
kubectl rollout status deployment/portal -n laboratorio
kubectl get pods -n laboratorio -o wide
kubectl describe deployment portal -n laboratorio
apply aceito prova apenas que a API validou o objeto. rollout status, conditions, Events, endpoints e teste funcional fornecem evidência adicional.
5.4 Expondo apenas no laboratório
kubectl port-forward -n laboratorio service/portal 8080:80
Port-forward é canal temporário para debug. Não é desenho de exposição em produção.
5.5 Cleanup seguro
kubectl delete namespace laboratorio
Antes de excluir, confirme context, namespace, recursos persistentes e reclaim policy. Namespace não é fronteira absoluta: objetos cluster-scoped e recursos externos podem permanecer.
Exercícios
- Compare Kind, serviço managed e kubeadm para um portal corporativo.
- Crie dois contexts com namespaces distintos e confirme o ativo.
- Explique por que
kubectl applysem erro não é Definition of Done.
Nota Zettelkasten — ZK-K8S-005
Título: Contexto operacional do kubectl
Todo comando Kubernetes é relativo a cluster, identidade e namespace; confirmar context reduz mudanças corretas no ambiente errado.
Capítulo 6 — Pods, lifecycle e health checks
6.1 Pod é a unidade de scheduling
Um Pod agrupa um ou mais containers que compartilham network namespace, endereço IP e volumes declarados. Containers no mesmo Pod comunicam-se por localhost. Eles devem possuir lifecycle fortemente acoplado; colocar frontend e banco no mesmo Pod impede scaling, atualização e recuperação independentes.
Pods são efêmeros. Um Pod substituto recebe novo UID e geralmente novo IP. A identidade durável deve vir de Service, volume persistente ou controller apropriado, não do Pod individual.
6.2 Fases, states e conditions
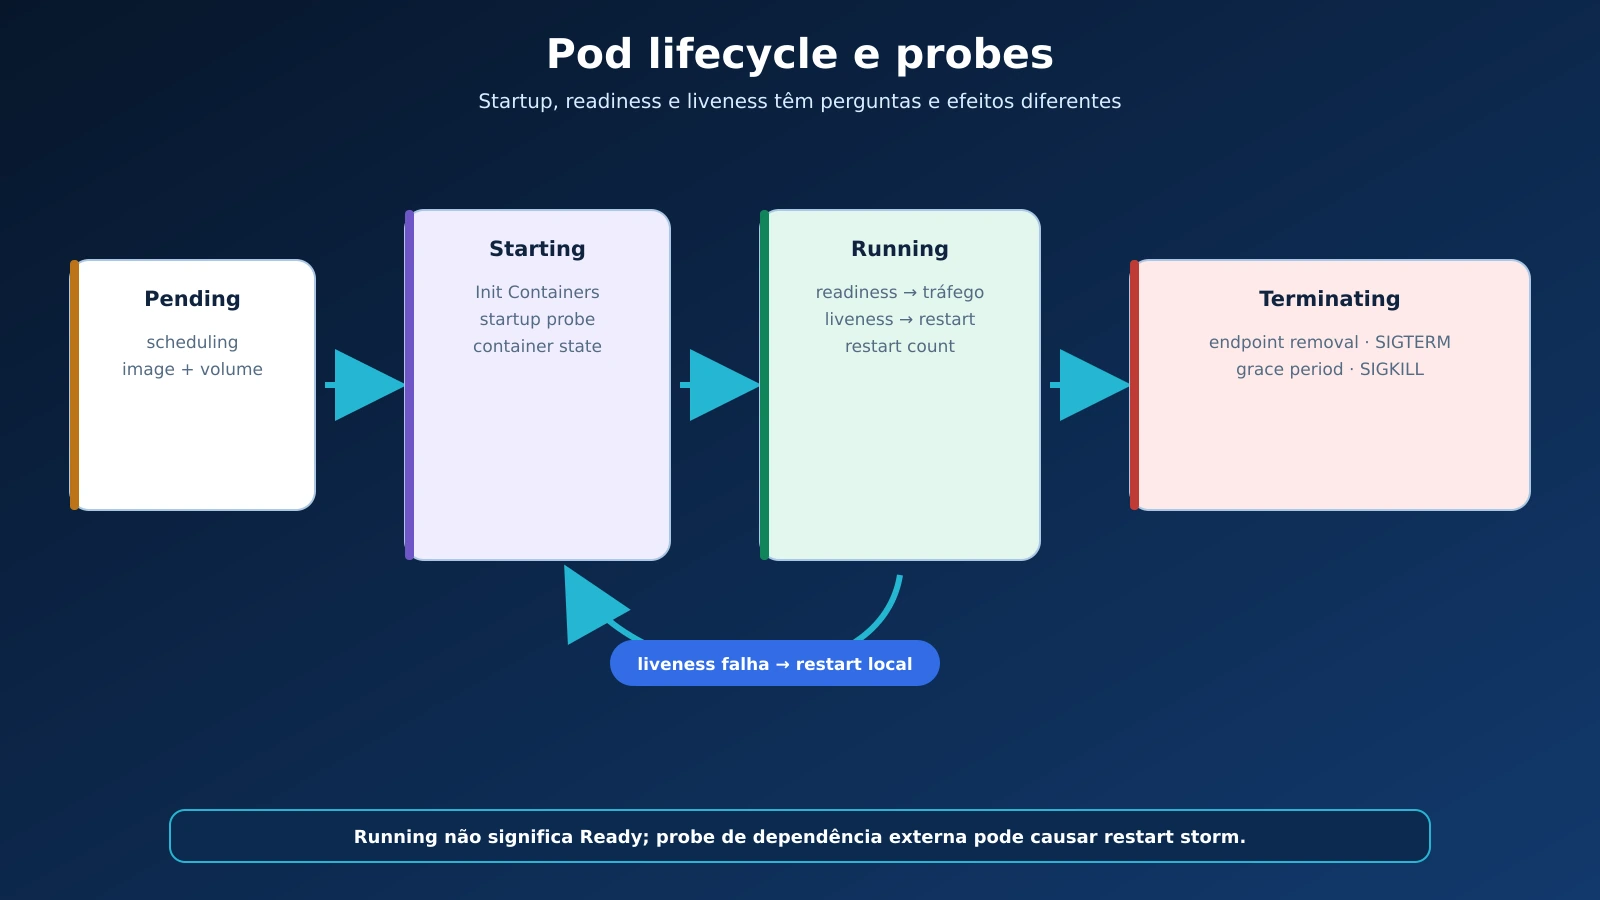
Figura 4 — Lifecycle do Pod, efeito das probes e sequência de encerramento gracioso.
- Pod phase:
Pending,Running,Succeeded,FailedouUnknown; - container state:
Waiting,RunningouTerminated; - conditions: sinais como
PodScheduled,Initialized,ContainersReadyeReady; - restart count: quantas vezes o container reiniciou no mesmo Pod.
Running não significa pronto para tráfego. Um container pode estar executando enquanto a aplicação ainda carrega cache ou está incapaz de responder.
6.3 Init Containers e sidecars
Init Containers executam sequencialmente antes dos containers de aplicação. Servem para preparação curta e idempotente, não para migration global que vários Pods podem executar ao mesmo tempo.
Sidecar é um container auxiliar com lifecycle relacionado ao principal: proxy, log shipper ou sincronizador. O custo de CPU e memória do sidecar participa do scheduling e deve ser declarado.
6.4 Probes
| Probe | Pergunta | Efeito da falha |
|---|---|---|
| startup | “a aplicação terminou de iniciar?” | protege liveness/readiness durante startup lento |
| readiness | “pode receber tráfego agora?” | remove endpoint do Service |
| liveness | “o processo está irrecuperavelmente travado?” | reinicia o container |
Uma liveness probe que depende de banco remoto pode reiniciar todos os Pods durante falha do banco, agravando o incidente. Readiness deve refletir capacidade de atender aquela requisição; liveness deve detectar estado que reinício local consegue corrigir.
startupProbe:
  httpGet:
    path: /health/startup
    port: http
  failureThreshold: 30
  periodSeconds: 2
readinessProbe:
  httpGet:
    path: /health/ready
    port: http
  periodSeconds: 5
livenessProbe:
  httpGet:
    path: /health/live
    port: http
  periodSeconds: 10
  failureThreshold: 3
6.5 Restart não é rescheduling
Kubelet pode reiniciar um container dentro do mesmo Pod conforme restartPolicy. Se o Node falhar, um controller cria outro Pod em Node disponível. Um Pod criado diretamente não ganha replicação automática.
6.6 Termination graciosa
Durante término, o Pod recebe deletionTimestamp, endpoints deixam de ser usados e o kubelet inicia o encerramento. A aplicação deve:
- falhar readiness para não aceitar nova carga;
- receber
SIGTERM; - concluir requests e jobs em andamento;
- sair antes de
terminationGracePeriodSeconds; - tolerar que encerramento e remoção de endpoint não sejam instantâneos.
preStop pode ajudar, mas seu tempo conta dentro do grace period. Sleep arbitrário não substitui protocolo correto.
6.7 Debug básico
kubectl get pod portal-abc -n laboratorio -o yaml
kubectl describe pod portal-abc -n laboratorio
kubectl logs portal-abc -n laboratorio -c web --previous
kubectl exec -n laboratorio portal-abc -c web -- printenv
--previous é essencial quando o container reiniciou. exec deve ser limitado por RBAC, pois permite executar código dentro do workload.
Exercícios
- Defina startup, readiness e liveness para uma API Flask.
- Explique por que banco e aplicação no mesmo Pod são um acoplamento inadequado.
- Diferencie container restart, Pod replacement e Node recovery.
Nota Zettelkasten — ZK-K8S-006
Título: Health check com semântica
Startup, readiness e liveness respondem perguntas diferentes; probe errada transforma dependência externa em restart loop.
Capítulo 7 — Controllers e tipos de workload
7.1 Relação entre objetos
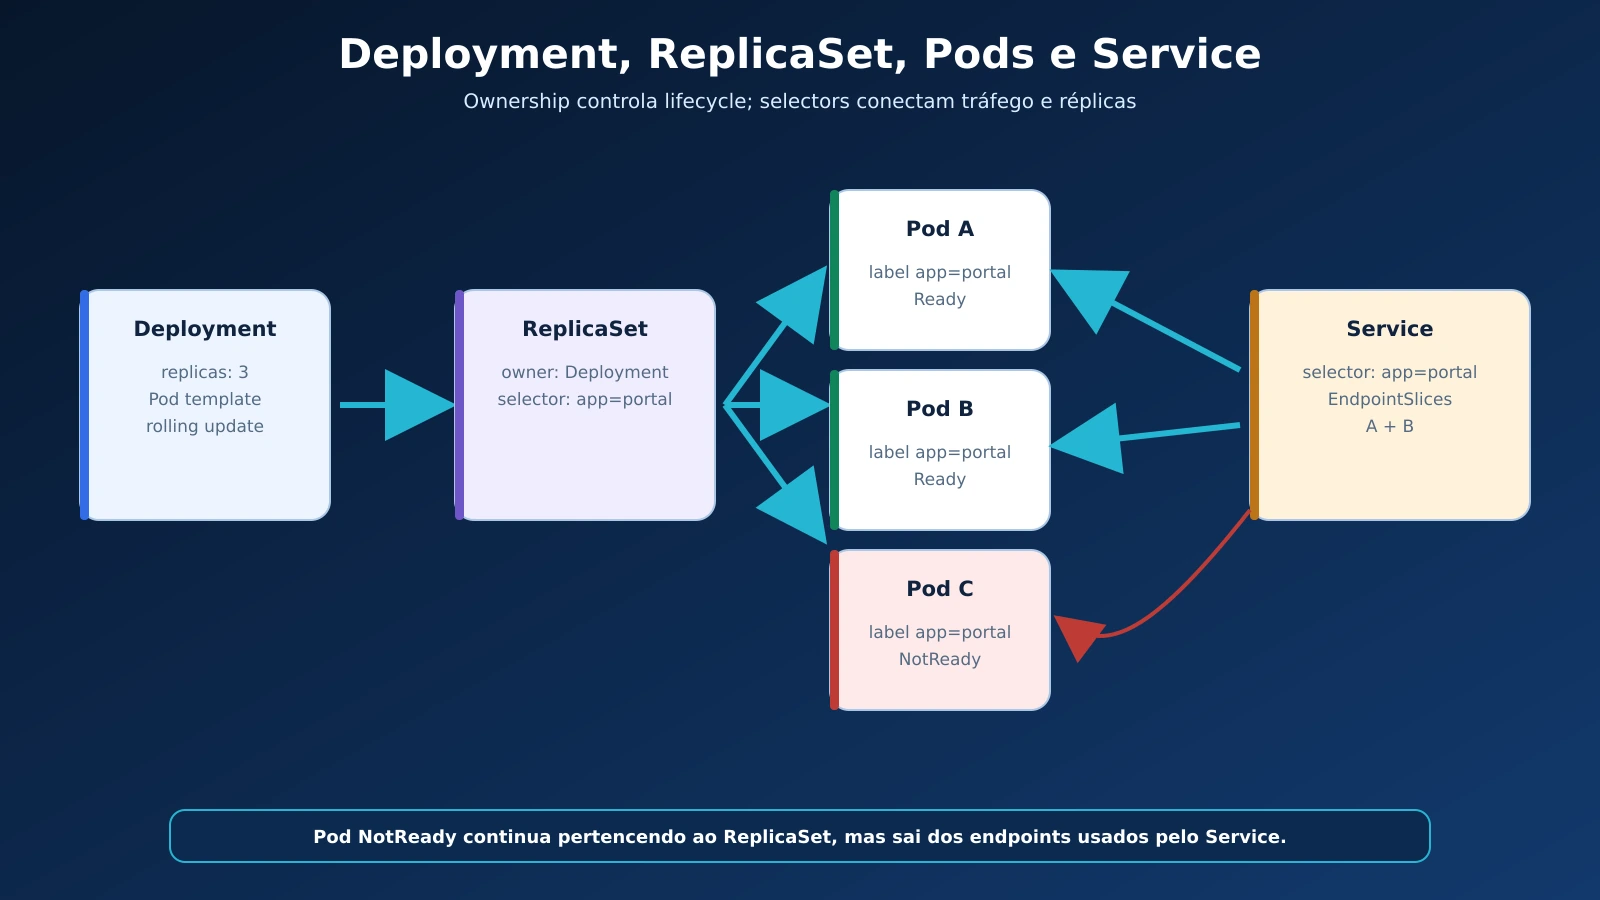
Figura 5 — Relação de ownership entre Deployment, ReplicaSet e Pods, e seleção independente pelo Service.
Deployment cria e gerencia ReplicaSets; ReplicaSet mantém Pods intercambiáveis; Service seleciona Pods por labels. Os objetos são relacionados por selectors e ownership, não por ordem textual do YAML.
7.2 Comparação
| Recurso | Use quando | Identidade | Atualização | Erro comum |
|---|---|---|---|---|
| Pod direto | debug ou primitive temporária | efêmera | manual | usar em produção sem controller |
| ReplicaSet | mecanismo de replicação | Pods intercambiáveis | limitada | gerenciar em vez de Deployment |
| Deployment | serviço stateless | Pods intercambiáveis | rolling update/rollback | colocar banco stateful |
| StatefulSet | identidade ou storage estável | ordinal e estável | ordenada/configurável | presumir HA da aplicação |
| DaemonSet | uma cópia por Node selecionado | ligada ao Node | rolling update | usar para workload comum |
| Job | execução até conclusão | tarefa finita | retries/completions | efeito externo não idempotente |
| CronJob | Jobs agendados | tarefa recorrente | schedule/concurrency | assumir execução exatamente uma vez |
Deployments gerenciam workloads normalmente stateless por updates declarativos [5]. StatefulSets preservam identidade aderente e são úteis para aplicações stateful [7]. DaemonSets executam facilidades locais do Node, como agentes de rede ou logs [8]. Jobs representam tarefas que chegam à conclusão [9].
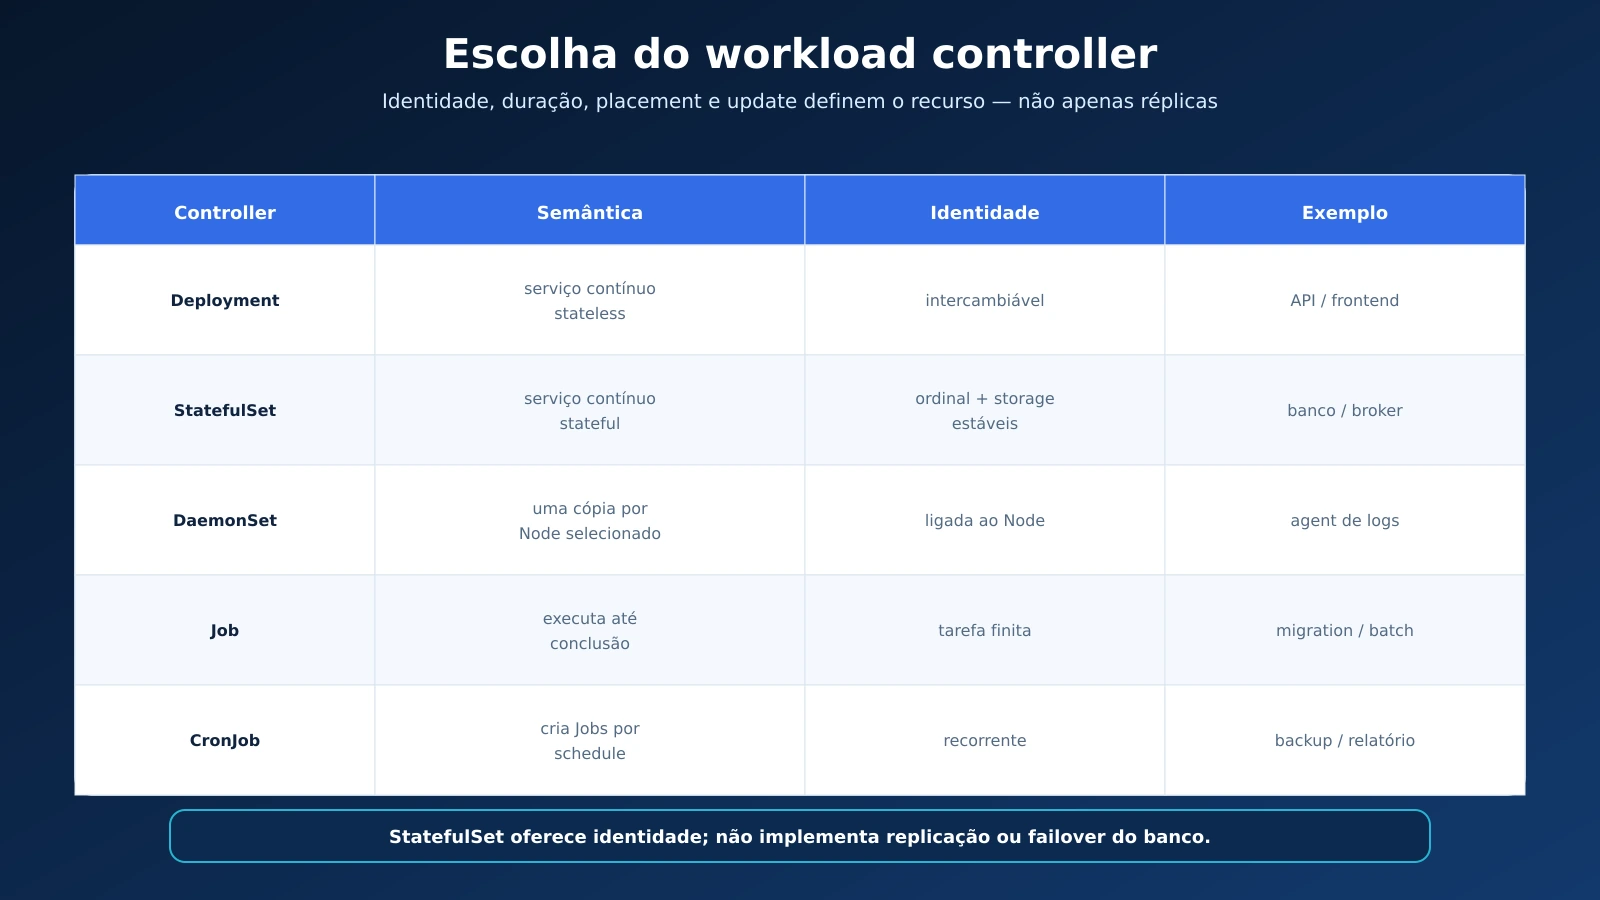
Figura 6 — Matriz de decisão entre Deployment, StatefulSet, DaemonSet, Job e CronJob.
7.3 Rolling update
maxUnavailable limita indisponibilidade durante rollout; maxSurge permite Pods adicionais. Ambos interagem com capacity, readiness e termination.
strategy:
  type: RollingUpdate
  rollingUpdate:
    maxUnavailable: 0
    maxSurge: 1
Esse desenho tenta preservar capacidade, mas exige espaço para o Pod extra. Se requests ocupam todos os Nodes, o rollout pode ficar bloqueado.
7.4 Rollback
kubectl rollout status deployment/portal -n producao
kubectl rollout history deployment/portal -n producao
kubectl rollout undo deployment/portal -n producao
Rollback do Deployment troca Pod template. Ele não reverte automaticamente migration, mensagem publicada ou contrato externo.
7.5 StatefulSet não transforma banco em distribuído
StatefulSet fornece nome e volume estáveis. Replicação, election, consistency, backup e failover pertencem ao banco ou Operator. Executar PostgreSQL com três réplicas idênticas não cria um cluster PostgreSQL válido.
7.6 Jobs e idempotência
Jobs podem recriar Pods e repetir execução. CronJobs podem atrasar ou sobrepor instâncias conforme concurrencyPolicy. Qualquer efeito externo deve usar chave de idempotência, checkpoint ou transação apropriada.
Exercícios
- Escolha o controller para API, worker, log agent, migration e backup.
- Explique por que rollback de image não reverte schema do banco.
- Projete um Job seguro para importar registros sem duplicação.
Nota Zettelkasten — ZK-K8S-007
Título: Controller conforme semântica do workload
O controller correto representa identidade, duração, placement e estratégia de atualização; escolher apenas pelo número de réplicas perde essas garantias.
Capítulo 8 — ConfigMaps, Secrets e configuração
8.1 Separar image e configuração
Uma mesma image deve atravessar ambientes. URL, feature flag não sensível e nível de log entram por configuração. Senhas, tokens e chaves exigem gestão de secrets.
8.2 ConfigMap
ConfigMap armazena pares de configuração não confidencial. O objeto tem limite de 1 MiB e não foi projetado como file store [10]. Pode ser consumido por environment variables, argumentos ou volume.
apiVersion: v1
kind: ConfigMap
metadata:
  name: portal-config
data:
  LOG_LEVEL: INFO
  WORKER_QUEUE: default
Environment variables são capturadas no início do processo. Volume projetado pode atualizar depois, mas a aplicação precisa reler e existe atraso de propagação. Rollout por checksum torna a mudança explícita e auditável.
8.3 Secret não significa criptografado
Secret separa dado sensível do PodSpec, mas seu conteúdo base64 não é criptografia. Por padrão, Secrets podem permanecer sem criptografia no etcd; habilite encryption at rest, TLS, RBAC mínimo e restrição de acesso [11].
kubectl create secret generic portal-db \
  --from-literal=username=portal \
  --from-file=password=./senha.txt \
  --dry-run=client -o yaml
Mesmo com --dry-run, o YAML resultante contém o secret codificado. Não faça commit dele.
8.4 External secret management
Em produção, é comum integrar Vault ou secret manager do cloud provider por CSI driver ou controller. O cluster recebe referência ou cópia sincronizada. Avalie:
- quem autentica o Pod;
- onde o valor é materializado;
- como ocorre rotation;
- se o secret aparece em environment, volume, log ou core dump;
- comportamento quando o provider fica indisponível;
- revogação e auditoria.
8.5 Downward API
Downward API expõe metadata do próprio Pod, como namespace, name e labels. É útil para logs e telemetry sem duplicar configuração.
8.6 Configuration drift
Editar ConfigMap com kubectl edit quebra rastreabilidade. Prefira Git, review e deployment tool. Reiniciar Pods sem registrar por que a configuração mudou corrige sintoma e preserva drift.
Exercícios
- Classifique dez valores entre image, ConfigMap, Secret e serviço externo.
- Explique por que base64 não protege uma senha.
- Desenhe rotation de token sem indisponibilidade.
Nota Zettelkasten — ZK-K8S-008
Título: Configuração tem lifecycle
Configuração e secret possuem criação, distribuição, atualização, observação, rotation e revogação; injetar valor no Pod é apenas uma etapa.
Capítulo 9 — Services, DNS e service discovery
9.1 Por que Service existe
Pods mudam de IP. Service cria identidade virtual estável e seleciona backends por labels. O controller mantém EndpointSlices, que representam endpoints elegíveis [12].
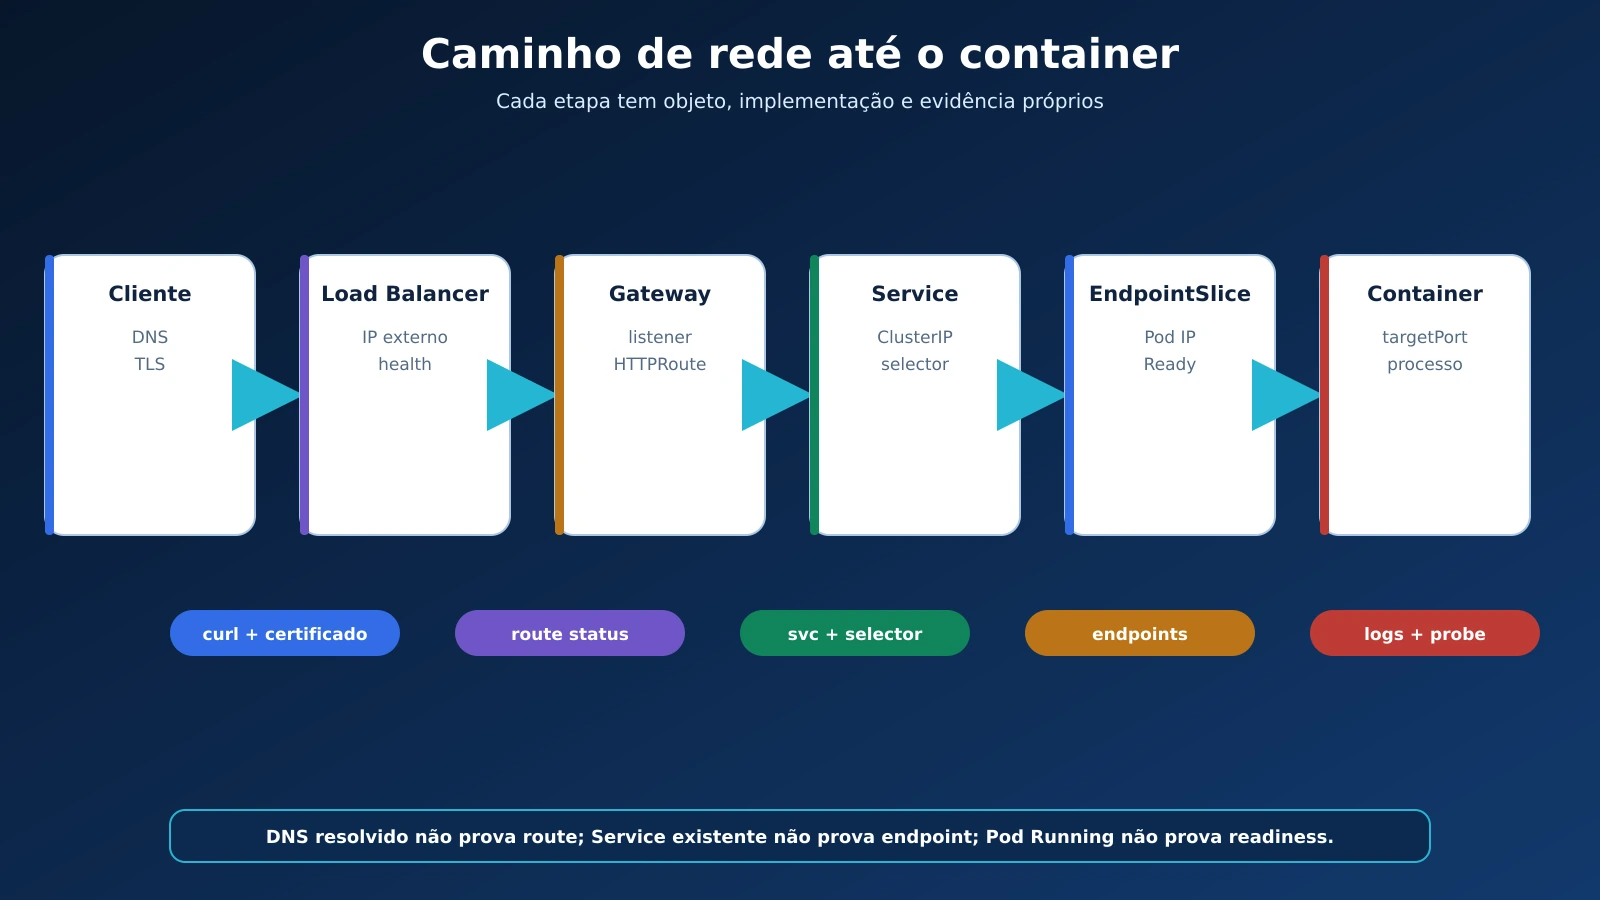
Figura 7 — Caminho completo de uma requisição, do cliente ao processo dentro do container.
9.2 Tipos de Service
| Tipo | Alcance | Uso típico |
|---|---|---|
ClusterIP |
interno ao cluster | comunicação entre workloads |
NodePort |
porta em cada Node | integração específica ou base de LoadBalancer |
LoadBalancer |
endereço externo via integração | exposição L4 em cloud/bare metal suportado |
ExternalName |
alias DNS | apontar nome interno para nome externo |
headless (clusterIP: None) |
DNS retorna endpoints | discovery direto, comum com StatefulSet |
9.3 Selector e portas
apiVersion: v1
kind: Service
metadata:
  name: portal
spec:
  selector:
    app.kubernetes.io/name: portal
  ports:
    - name: http
      port: 80
      targetPort: http
port é a porta do Service; targetPort é a porta no backend. Nomear portas reduz acoplamento numérico. Selector errado produz zero endpoint ou aponta para versão indevida.
9.4 DNS
Dentro do mesmo namespace, portal normalmente resolve o Service. Entre namespaces, use portal.atendimento; a forma completa segue portal.atendimento.svc.cluster.local, considerando o cluster domain configurado.
DNS bem-sucedido não prova conectividade. Diagnóstico separa:
- resolução do nome;
- presença de EndpointSlices;
- rota e NetworkPolicy;
- porta e processo;
- protocolo e TLS;
- resposta da aplicação.
9.5 Service não é health check de negócio
Readiness decide se o Pod entra nos endpoints. Service distribui tráfego entre endpoints disponíveis; ele não compreende transação ou sessão da aplicação. Sticky session pode existir em implementações específicas, mas estado de usuário deve preferir store externo.
Exercícios
- Explique o caminho de
portal.atendimentoaté um Pod. - Diagnostique um Service sem endpoints.
- Compare ClusterIP, headless Service e LoadBalancer.
Nota Zettelkasten — ZK-K8S-009
Título: Service desacopla identidade e instância
Service oferece identidade estável sobre Pods efêmeros; selectors, EndpointSlices e readiness determinam os backends reais.
Capítulo 10 — Exposição externa: Ingress e Gateway API
10.1 Camadas de exposição
- Service
LoadBalancer: exposição de protocolo L4 suportado; - Ingress: roteamento HTTP/HTTPS consolidado;
- Gateway API: conjunto extensível e orientado a papéis para infraestrutura e routes.
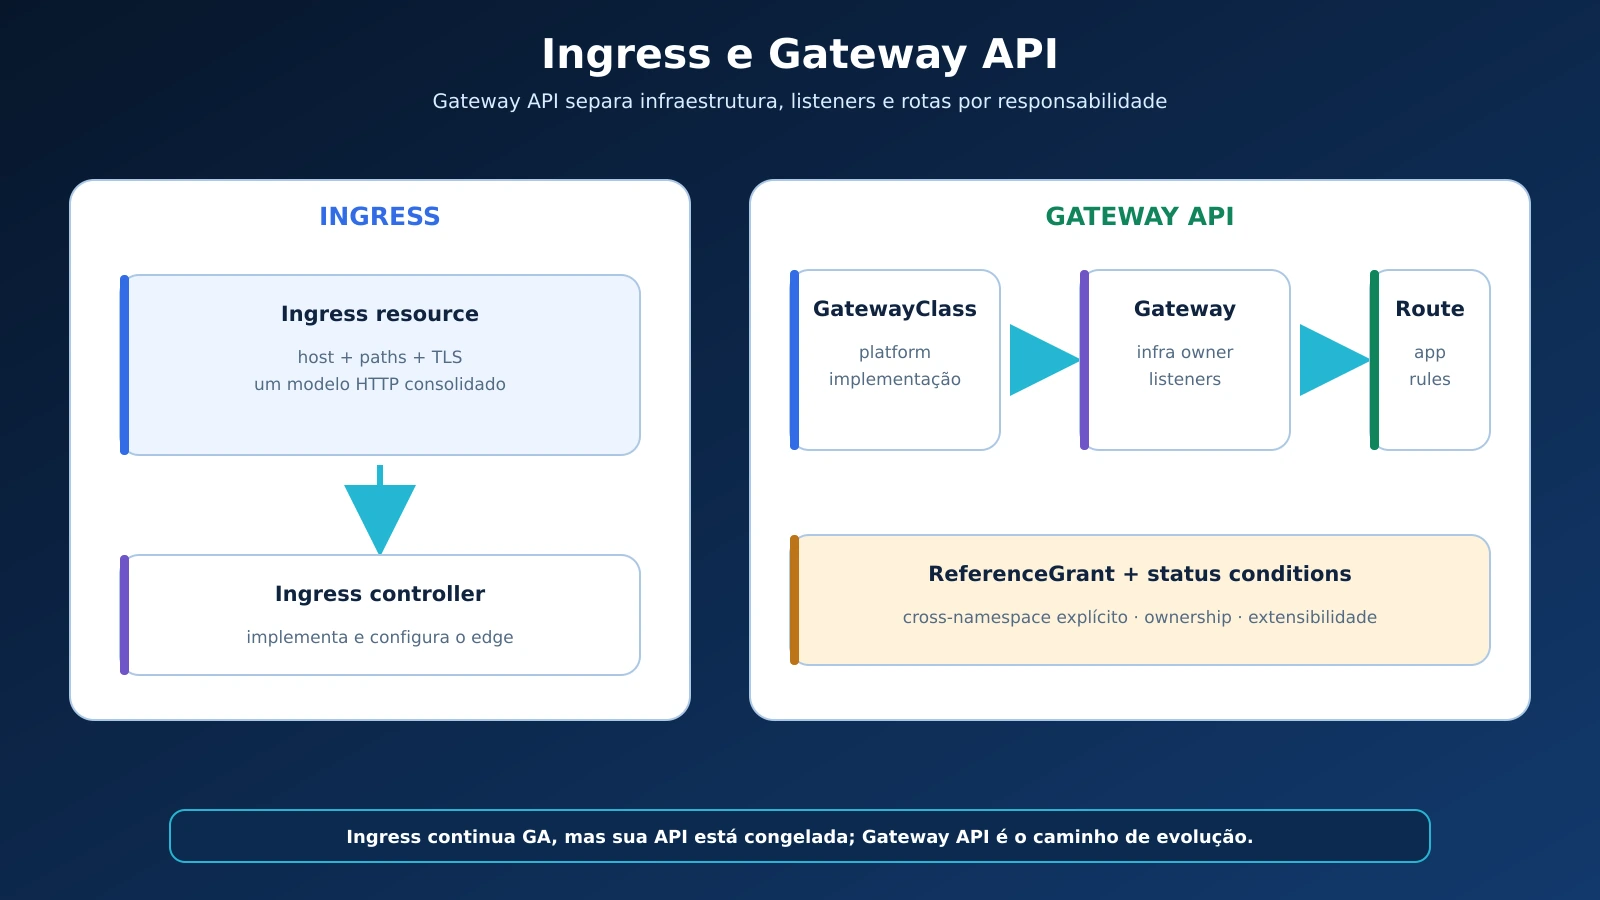
Figura 8 — Comparação estrutural entre Ingress e o modelo orientado a papéis da Gateway API.
10.2 Ingress precisa de controller
Criar um objeto Ingress não configura tráfego sem Ingress controller. A API Ingress permanece GA, mas está congelada; o projeto recomenda Gateway API para evolução de recursos [13].
10.3 Gateway API
Gateway API separa responsabilidades:
- GatewayClass: implementação administrada pela plataforma;
- Gateway: listener e infraestrutura compartilhada;
- HTTPRoute/TCPRoute: regra controlada pela equipe da aplicação;
- ReferenceGrant: autorização explícita para referência cross-namespace.
Essa divisão evita entregar configuração integral do load balancer a cada equipe [14].
10.4 TLS
Decida onde TLS termina:
- no load balancer externo;
- no Gateway/Ingress controller;
- novamente no backend por TLS ou mTLS.
Certificado, private key, hostname, redirect HTTP→HTTPS, cipher policy e rotation precisam ser operados. “Ingress com TLS” não prova criptografia até o Pod.
10.5 Preservação de origem e headers
Aplicação deve confiar em X-Forwarded-* somente quando a cadeia de proxies é conhecida. Aceitar header do cliente diretamente permite falsificar scheme ou IP. Configure proxy trust e logs de correlação.
10.6 Teste por camadas
kubectl get gateway,httproute -A
kubectl describe httproute portal -n atendimento
kubectl get endpointslice -n atendimento -l kubernetes.io/service-name=portal
curl -vk --resolve portal.example.com:443:203.0.113.10 \
  https://portal.example.com/health/ready
O IP é ilustrativo. Em produção, valide DNS, certificado, route status, policy e backend.
Exercícios
- Compare Service LoadBalancer, Ingress e Gateway API.
- Desenhe ownership entre platform team e application team.
- Explique por que TLS no edge pode não proteger tráfego interno.
Nota Zettelkasten — ZK-K8S-010
Título: Exposição externa orientada por papéis
Gateway API separa infraestrutura compartilhada e rotas da aplicação, tornando ownership e referências entre namespaces explícitos.
Capítulo 11 — Pod networking, CNI e NetworkPolicy
11.1 Modelo de rede
O modelo Kubernetes pressupõe que cada Pod tenha IP próprio e possa comunicar-se com outros Pods sem NAT entre eles, salvo policy ou implementação que restrinja. O CNI plugin cria interfaces, atribui endereços e programa o data plane. Kubernetes define o modelo e as APIs; o plugin implementa a rede.
11.2 Quatro caminhos diferentes
- container → container no mesmo Pod:
localhost; - Pod → Pod: rede CNI;
- Pod → Service: ClusterIP, DNS e data plane do Service;
- cliente externo → workload: LB/Gateway/Ingress → Service → Pod.
Confundir os caminhos leva a diagnóstico aleatório. Um Pod pode alcançar outro por IP e falhar via Service por selector ou porta; pode alcançar Service internamente e falhar externamente por route ou TLS.
11.3 NetworkPolicy
NetworkPolicy controla tráfego L3/L4 entre Pods e redes externas, desde que o network plugin implemente enforcement [15]. Criar o objeto em CNI sem suporte produz falsa sensação de segurança.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: api-ingress
  namespace: atendimento
spec:
  podSelector:
    matchLabels:
      app.kubernetes.io/component: api
  policyTypes: [Ingress, Egress]
  ingress:
    - from:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: gateway-system
      ports:
        - protocol: TCP
          port: 8000
  egress:
    - to:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: data
      ports:
        - protocol: TCP
          port: 5432
O exemplo omite DNS; em um default-deny real, a aplicação pode deixar de resolver nomes. Políticas precisam considerar DNS, APIs externas, telemetry e endpoints de autenticação.
11.4 Default deny e allowlist
Uma estratégia madura começa com inventário de fluxos e aplica default-deny por etapas. Bloquear tudo em produção sem observação prévia pode interromper health checks, DNS e monitoring. Use audit, ambiente de homologação e testes de conectividade.
11.5 NetworkPolicy não é firewall universal
Ela normalmente atua sobre tráfego de Pods em L3/L4. Não interpreta usuário HTTP, payload malicioso ou regra de negócio. Combine com:
- autenticação e autorização na aplicação;
- Gateway/WAF quando apropriado;
- mTLS/service mesh conforme ameaça;
- firewall de cloud/VPC;
- egress gateway ou proxy;
- runtime e node hardening.
11.6 Troubleshooting de rede
kubectl get pod -n atendimento -o wide
kubectl get svc,endpointslice -n atendimento
kubectl get networkpolicy -A
kubectl run net-debug --rm -it --image=curlimages/curl -- sh
Imagens de debug também fazem parte da supply chain. Não deixe Pod privilegiado permanente apenas por conveniência.
Exercícios
- Desenhe os quatro caminhos de rede de uma API.
- Corrija a policy de exemplo para permitir DNS de forma controlada.
- Explique por que policy existente pode não estar sendo aplicada.
Nota Zettelkasten — ZK-K8S-011
Título: Rede Kubernetes depende de implementação
As APIs descrevem intenção; CNI, service data plane e controllers implementam conectividade. Diagnóstico precisa identificar qual camada falhou.
Capítulo 12 — Requests, limits, QoS e quotas
12.1 Recursos são contrato de scheduling e execução
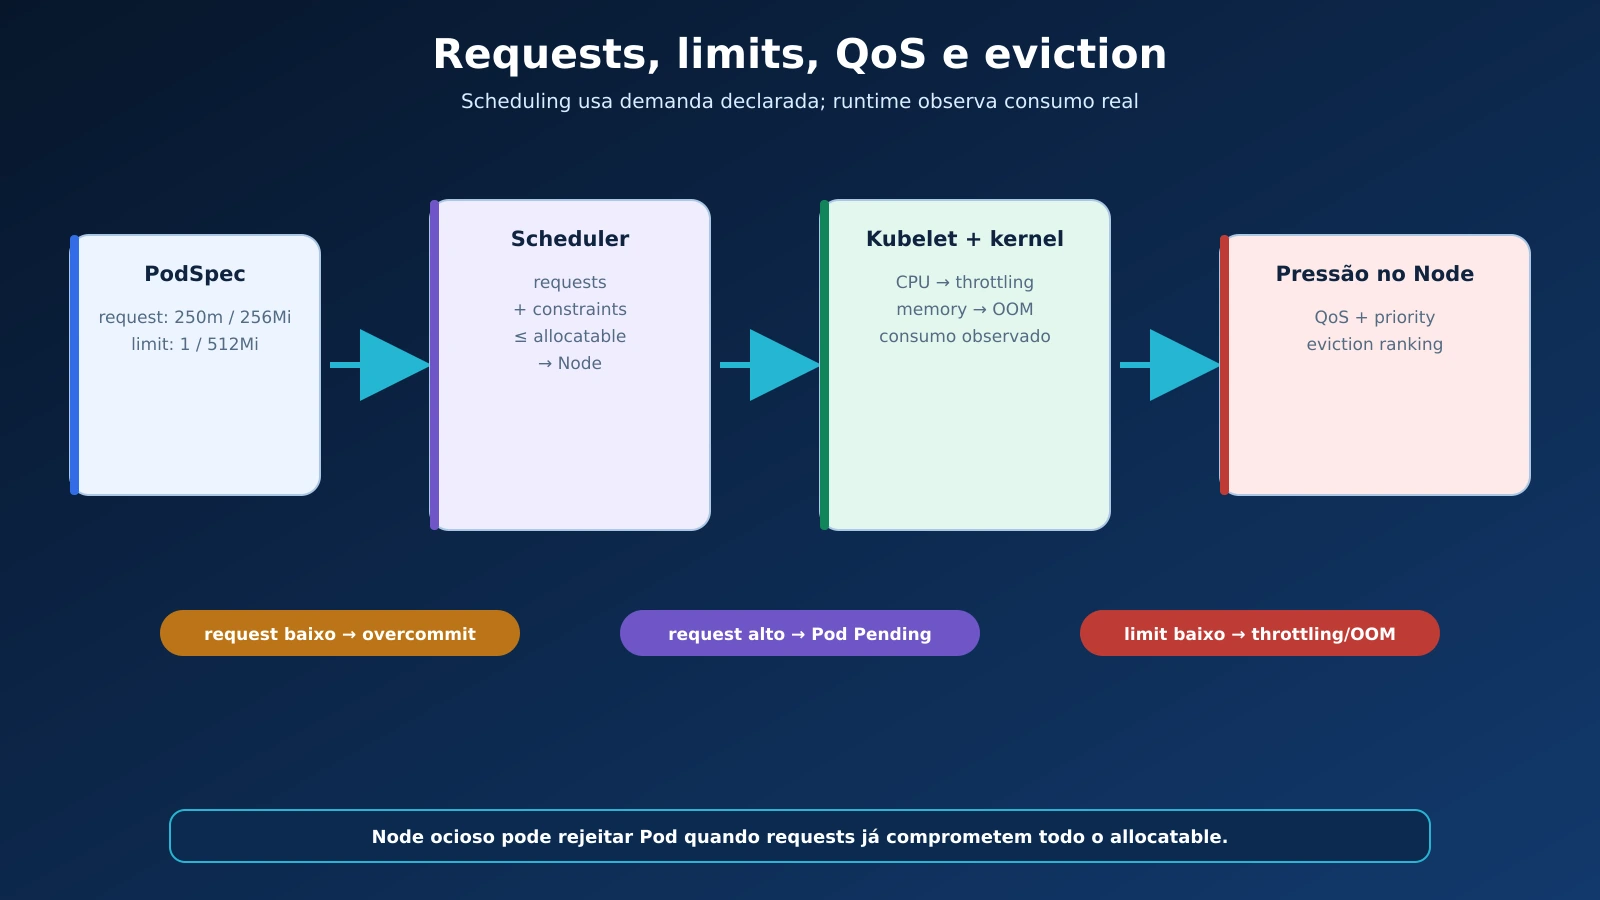
Figura 9 — Requests no scheduling, limits no runtime e influência de QoS durante pressão no Node.
requests influenciam placement: o scheduler procura Node com capacidade alocável. limits são aplicados no runtime pelo kubelet e kernel [16]. CPU e memória não se comportam da mesma forma:
- CPU acima do limit sofre throttling;
- memória acima do limit pode levar a OOM kill;
- uso acima do request pode ocorrer se houver capacidade;
- request muito baixo causa overcommit e instabilidade;
- request muito alto desperdiça capacity e bloqueia scheduling.
resources:
  requests:
    cpu: 250m
    memory: 256Mi
  limits:
    cpu: "1"
    memory: 512Mi
250m representa 0,25 CPU. 256Mi usa unidade binária; 256M é unidade decimal e não é igual.
12.2 Utilização relativa ao request
Para HPA baseado em CPU, a utilização média costuma comparar uso com request:
onde CPU_uso é o consumo medido e CPU_request é a CPU solicitada. Se um container usa 200m e pediu 250m, a utilização relativa é 80%, ainda que o Node possua CPUs livres.
12.3 QoS classes
- Guaranteed: requests iguais a limits para CPU e memória em todos os containers elegíveis;
- Burstable: algum request/limit existe, mas não atende Guaranteed;
- BestEffort: nenhum request ou limit de CPU/memória.
QoS influencia eviction sob pressão, mas não é garantia absoluta de sobrevivência. Priority, consumo acima de request e tipo de pressão também importam.
12.4 LimitRange e ResourceQuota
LimitRange define defaults e mínimos/máximos por objeto no namespace. ResourceQuota limita consumo agregado e quantidade de recursos. Quota sem requests bem calibrados apenas converte erro de capacidade em erro de admissão.
12.5 Capacity, allocatable e utilization
Node capacity inclui recurso físico. allocatable desconta reservas do sistema e kubelet. Scheduler compara requests agregados com allocatable, não consumo instantâneo. Um Node com CPU ociosa pode rejeitar Pod porque toda CPU já foi solicitada.
12.6 Rightsizing
Use histórico de percentis, picos, startup, garbage collection e SLO. Não ajuste request ao uso médio exato. Considere:
- baseline e pico;
- tempo de reação do autoscaler;
- cold start;
- memória não compressível;
- sidecars;
- margem para rollout e falha de Node.
Exercícios
- Calcule
U_cpupara 300m usados sobre request de 200m. - Classifique três Pods em Guaranteed, Burstable e BestEffort.
- Explique um Pod
Pendingem Node aparentemente ocioso.
Nota Zettelkasten — ZK-K8S-012
Título: Requests declaram demanda, não medem uso
Requests orientam scheduling e fairness; uso real orienta observação e rightsizing. Confundir os dois produz desperdício ou overcommit perigoso.
Capítulo 13 — Scheduling, placement e disruptions
13.1 Filtro, score e binding
O scheduler encontra Nodes viáveis, pontua os candidatos e registra o binding do Pod ao Node [17]. Depois, o kubelet daquele Node cria os containers.
13.2 Ferramentas de placement
| Recurso | Semântica | Exemplo |
|---|---|---|
nodeSelector |
requisito simples por label | workload em Nodes SSD |
| node affinity | required ou preferred com expressões | região, arquitetura, classe |
| pod affinity | aproximar Pods | cache próximo da aplicação |
| pod anti-affinity | separar Pods | réplicas em Nodes distintos |
| topology spread | distribuir por domínio | zonas e hosts |
| taint | Node repele Pods | Nodes GPU ou dedicados |
| toleration | Pod tolera taint | workload autorizado naquele pool |
Toleration não atrai o Pod; apenas remove uma restrição. Use junto com affinity quando o workload deve permanecer em pool dedicado [18].
13.3 Failure domains
Topology spread constraints distribuem Pods entre zonas, Nodes ou domínios definidos [19]. Três réplicas no mesmo Node oferecem replicação de processo, não tolerância à falha do Node.
13.4 Priority e preemption
PriorityClass influencia ordem e pode permitir preemption de Pods de menor prioridade. Usar prioridade máxima em todos os workloads elimina diferenciação. Preemption não cria capacity; apenas decide quem perde recurso.
13.5 Eviction
Eviction pode ocorrer por:
- pressão de memória, disco, inode ou PID no Node;
- drain administrativo;
- Node indisponível;
- preemption;
- policy ou manutenção.
Eventos, Pod status, Node conditions e logs do kubelet ajudam a distinguir OOMKilled, eviction por pressão e rollout normal.
13.6 PodDisruptionBudget
PDB limita indisponibilidade em disruptions voluntárias. Ele não impede falha física e não garante que um rollout mal configurado preserve SLO. Em preemption, respeito ao PDB pode ser best effort [20].
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: portal
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app.kubernetes.io/name: portal
PDB incompatível com número de réplicas pode impedir drain e upgrade.
Exercícios
- Distribua três réplicas entre duas zonas e vários Nodes.
- Explique diferença entre taint, toleration e node affinity.
- Crie cenário em que PDB bloqueia manutenção.
Nota Zettelkasten — ZK-K8S-013
Título: Placement expressa failure domains
Scheduling confiável combina demanda, restrições e topologia; número de réplicas sem distribuição não representa disponibilidade.
Capítulo 14 — Storage, PV, PVC, StorageClass e CSI
14.1 Container filesystem é efêmero
Dados gravados na layer do container desaparecem quando ele é substituído. Volume monta storage no Pod. Durabilidade, replicação e backup dependem do tipo e do backend.
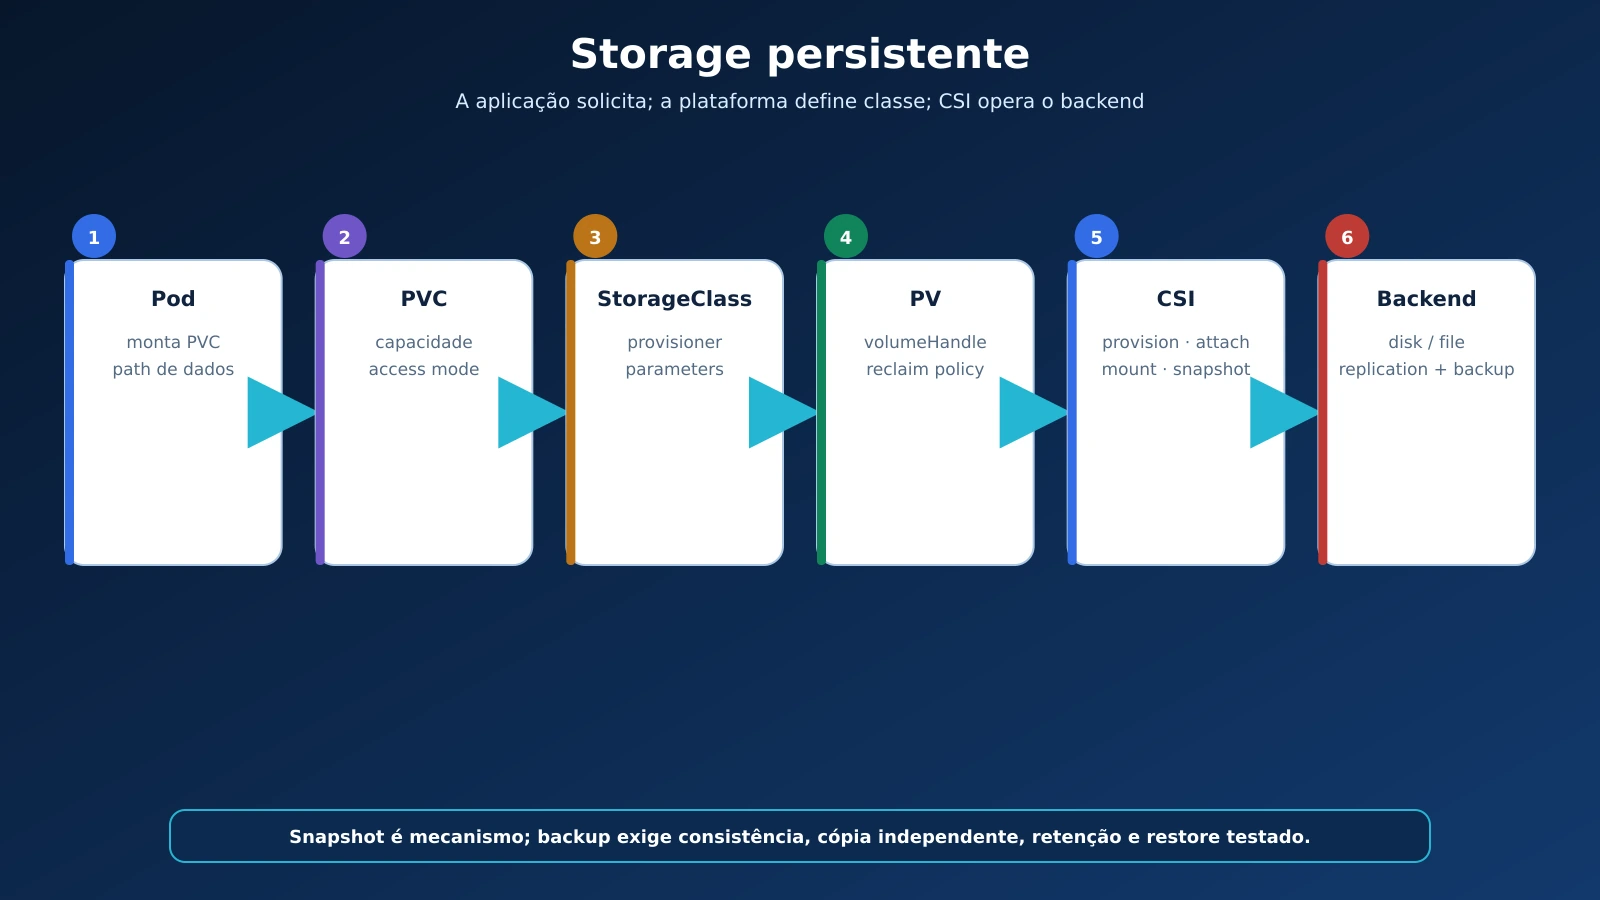
Figura 10 — Fluxo de storage entre Pod, PVC, StorageClass, PV, CSI driver e backend.
14.2 Objetos e responsabilidades
- PersistentVolume (PV): capacidade de storage disponível ao cluster;
- PersistentVolumeClaim (PVC): solicitação de storage do workload;
- StorageClass: classe, provisioner e parâmetros definidos pela plataforma;
- CSI driver: implementação que provisiona, anexa e monta volumes;
- VolumeSnapshot: representação de snapshot quando suportado.
PVC desacopla aplicação dos detalhes do backend [21]. Dynamic provisioning cria volume sob demanda pela StorageClass [22].
14.3 Access modes não são garantia universal
ReadWriteOnce, ReadOnlyMany, ReadWriteMany e modos relacionados descrevem formas de montagem suportadas. Eles não substituem mecanismo de locking da aplicação nem transformam filesystem em banco distribuído.
14.4 Reclaim policy
Delete: remover PV pode excluir storage do provider;Retain: storage permanece para recuperação manual.
Confirme policy antes de apagar namespace, PVC ou StatefulSet. “Recriar o manifesto” não recupera volume deletado.
14.5 StatefulSet e volumeClaimTemplates
Cada ordinal pode receber PVC próprio. Reduzir réplicas ou excluir StatefulSet normalmente não deve ser tratado como limpeza automática dos dados. Documente ownership, retenção e restore.
14.6 Snapshot não é backup completo
Snapshot pode ser crash-consistent e permanecer no mesmo failure domain ou account. Backup confiável possui:
- consistência da aplicação;
- cópia independente e criptografada;
- retenção e imutabilidade;
- inventário de metadata e secrets necessários;
- teste periódico de restore;
- RPO e RTO definidos.
14.7 Banco dentro ou fora do cluster
Banco managed reduz parte da operação de storage e failover. Banco no cluster pode ser válido com Operator maduro, storage adequado e equipe capacitada. A escolha depende de latência, compliance, custo, portability e responsabilidade operacional.
Exercícios
- Trace StorageClass → PVC → PV → CSI → backend.
- Compare
DeleteeRetaindurante exclusão acidental. - Escreva um teste de restore para PostgreSQL.
Nota Zettelkasten — ZK-K8S-014
Título: Persistência exige restore demonstrável
PV e snapshot fornecem mecanismos; durabilidade operacional só existe quando consistência, retenção, independência e restore são testados.
Capítulo 15 — Security: identidade, policy e supply chain
15.1 Modelo em camadas
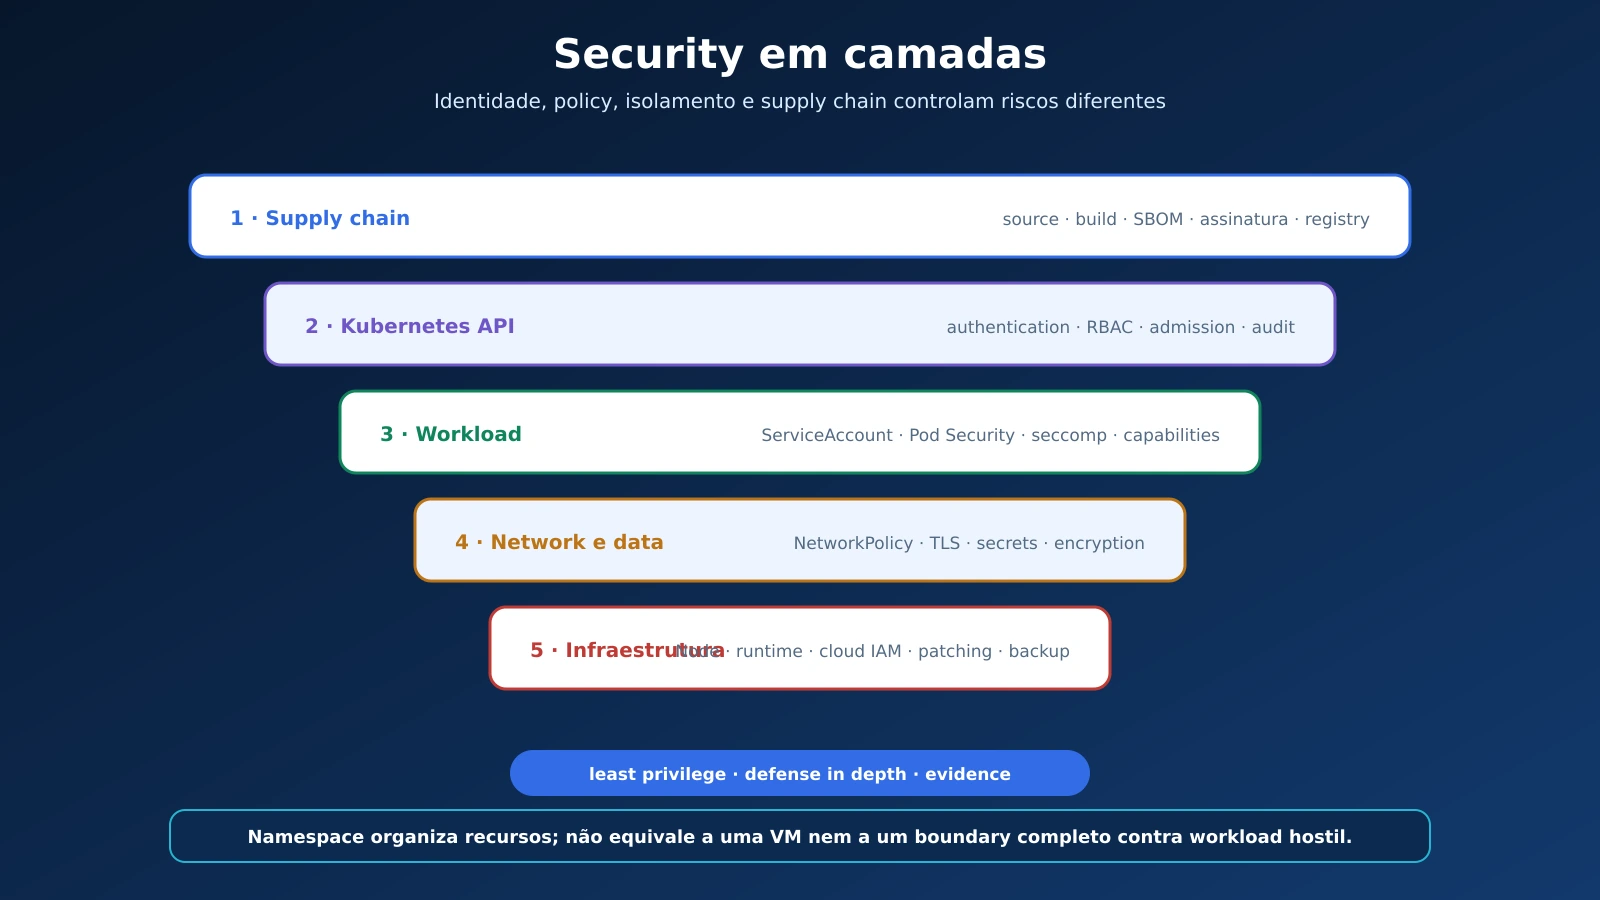
Figura 11 — Camadas complementares de security, da supply chain à infraestrutura.
Security em Kubernetes atravessa cloud/datacenter, cluster, container e aplicação. Um cluster privado não corrige image vulnerável; NetworkPolicy não corrige RBAC administrativo; RBAC não corrige SQL injection.
15.2 Autenticação, autorização e admission
O API server processa:
- authentication: quem faz o pedido;
- authorization: se pode executar verbo sobre recurso;
- admission: valida ou modifica o objeto;
- persistence: grava o objeto aceito.
RBAC associa Subjects a Roles/ClusterRoles por RoleBindings/ClusterRoleBindings. Evite curingas e cluster-admin; permissões para criar Pods podem permitir montar Secrets, usar ServiceAccounts ou alcançar Nodes, gerando privilege escalation [23].
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: pod-reader
  namespace: atendimento
rules:
  - apiGroups: [""]
    resources: ["pods", "pods/log"]
    verbs: ["get", "list", "watch"]
15.3 ServiceAccounts
ServiceAccount é identidade de workload perante a Kubernetes API. Não monte token automaticamente quando o Pod não precisa:
automountServiceAccountToken: false
Quando precisa, use ServiceAccount exclusivo, audience e duração apropriadas. Compartilhar default entre aplicações impede least privilege.
15.4 Pod Security Standards
Os níveis privileged, baseline e restricted formam políticas cumulativas [24]. Um workload seguro normalmente busca:
securityContext:
  runAsNonRoot: true
  seccompProfile:
    type: RuntimeDefault
containers:
  - name: web
    securityContext:
      allowPrivilegeEscalation: false
      readOnlyRootFilesystem: true
      capabilities:
        drop: ["ALL"]
O manifesto precisa de volumes graváveis para diretórios necessários. Ativar root filesystem read-only sem entender a aplicação apenas desloca a falha para runtime.
15.5 Secrets e encryption
Restrinja verbos get, list e watch sobre Secrets; uma lista pode revelar todos os valores autorizados. Habilite encryption at rest de etcd, proteja backups e rotacione chaves. Secrets expostos como environment podem aparecer em dumps e ferramentas de processo.
15.6 Network e multi-tenancy
Namespace organiza e delimita muitos recursos, mas não é VM. Multi-tenancy exige combinação de RBAC, quotas, Pod Security, NetworkPolicy, admission, node isolation e observability. Workload hostil pode exigir clusters separados ou runtime sandboxed.
15.7 Supply chain
Proteja:
- source e review;
- build runner;
- dependências e base image;
- registry e tags imutáveis;
- assinatura/provenance;
- admission policy;
- runtime e patching;
- SBOM e resposta a vulnerabilidade.
Scan sem policy vira relatório ignorado. Policy sem processo de exceção incentiva bypass.
15.8 Audit e break-glass
Audit logs registram chamadas à API conforme policy. Conta break-glass deve ser protegida, monitorada, testada e usada apenas por incidente. Credencial administrativa cotidiana não é break-glass.
Exercícios
- Explique uma privilege escalation possível por criação de Pods.
- Aplique
restricteda uma API e registre incompatibilidades reais. - Desenhe a cadeia source → image → admission → runtime.
Nota Zettelkasten — ZK-K8S-015
Título: Segurança Kubernetes é composição
Identidade, RBAC, admission, Pod Security, network, secrets e supply chain reduzem riscos distintos; nenhuma camada isolada fornece boundary completa.
Capítulo 16 — Observability e troubleshooting
16.1 Os quatro sinais operacionais
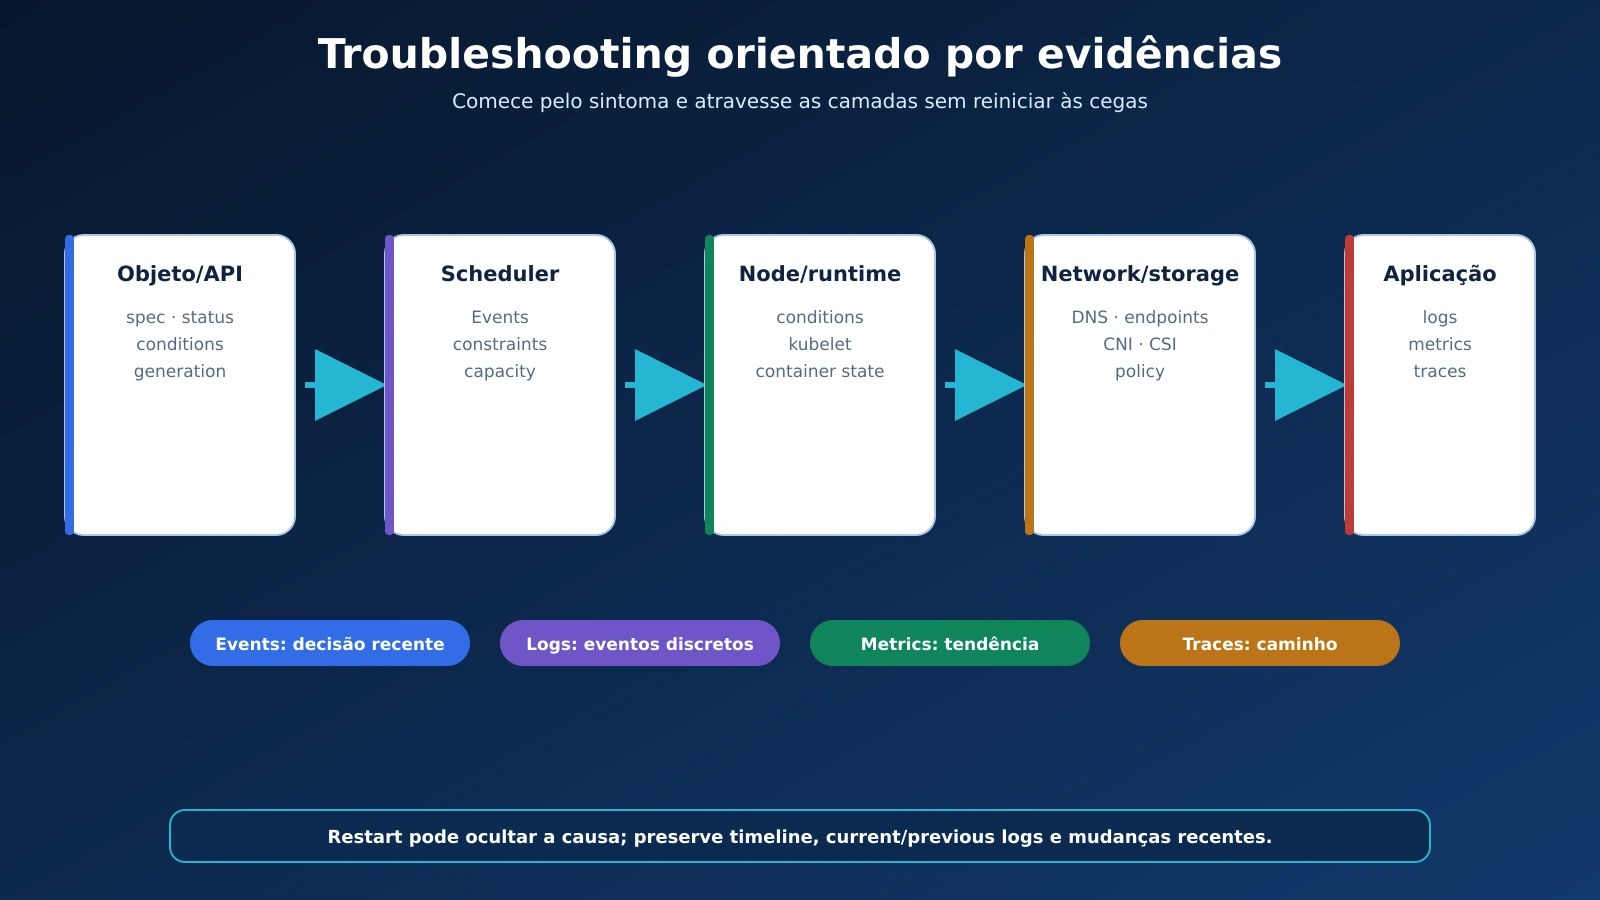
Figura 12 — Sequência de troubleshooting apoiada por Events, logs, metrics e traces.
- Events: decisões e falhas recentes de objetos e componentes;
- logs: eventos discretos produzidos pela aplicação e plataforma;
- metrics: séries temporais agregáveis;
- traces: caminho de uma requisição entre serviços.
Nenhum sinal substitui os demais. kubectl logs mostra o processo, não a causa de um Pod nunca ter sido agendado. Events mostram FailedScheduling, mas não explicam uma query lenta dentro da aplicação.
16.2 Health não é observability
Probe responde uma pergunta binária operacional. Observability permite formular perguntas novas a partir do estado externo. Uma API pode passar readiness e ainda ter p99 acima do SLO.
16.3 Resource metrics
Metrics Server coleta CPU e memória dos kubelets, implementa Metrics API e alimenta kubectl top e autoscalers [25]. Ele não é uma plataforma completa de monitoramento histórico.
kubectl top nodes
kubectl top pods -n atendimento --containers
Em Kubernetes v1.37, Metrics API metrics.k8s.io/v1 tornou-se stable, mas o cluster ainda precisa de Metrics Server ou implementação compatível [2,25].
16.4 Golden Signals e RED
Para services, monitore:
- rate: requisições por segundo;
- errors: falhas por classe;
- duration: distribuição de latência, especialmente percentis;
- saturation: filas, pool, CPU, memória e conexões.
Média esconde cauda. Se 99 requests respondem em 100 ms e uma em 10 s, a média parece aceitável para muitos contextos, mas o p99 revela experiência ruim.
16.5 Logging estruturado
Inclua timestamp, severity, service, version, namespace, Pod, trace_id e correlation_id. Não registre token, cookie, conteúdo pessoal ou Secret. Pods são efêmeros; logs precisam sair do Node para retenção central.
16.6 Método de troubleshooting
- confirme context, namespace e janela temporal;
- descreva o sintoma observável;
- verifique objeto desejado e conditions;
- examine Events em ordem temporal;
- identifique Node, Pod, container e versão;
- leia logs atuais e anteriores;
- teste DNS, endpoints e conectividade por camadas;
- correlacione metrics e traces;
- formule hipótese e experimento mínimo;
- registre correção e teste de regressão.
16.7 Diagnósticos frequentes
| Sintoma | Primeiras hipóteses | Evidência |
|---|---|---|
Pending |
request sem capacity, affinity, taint, PVC | describe pod, Events |
ImagePullBackOff |
image/tag, credencial, DNS, registry | Events e imagePullSecret |
CrashLoopBackOff |
processo sai, config, permission | logs e --previous |
OOMKilled |
limit, leak, pico | last state e memory metrics |
Running sem tráfego |
readiness, selector, port | conditions e EndpointSlices |
| 503 no edge | route, Service, zero endpoints | Gateway/Ingress status |
Node NotReady |
kubelet, runtime, rede, disco | Node conditions e logs |
16.8 Ephemeral containers
Ephemeral containers permitem debug quando a image não possui shell. Seu uso é poderoso e sensível; controle pods/ephemeralcontainers por RBAC e registre a ação.
Exercícios
- Diagnostique
Runningcom Service sem endpoint. - Diferencie CrashLoopBackOff por aplicação e por Secret ausente.
- Defina Golden Signals para um worker RQ.
Nota Zettelkasten — ZK-K8S-016
Título: Troubleshooting orientado por camadas
Diagnóstico Kubernetes parte de estado e evidência: API, scheduler, Node, runtime, network, storage e aplicação são investigados separadamente antes da conclusão.
Capítulo 17 — Autoscaling: HPA, VPA e Nodes
17.1 Três decisões diferentes
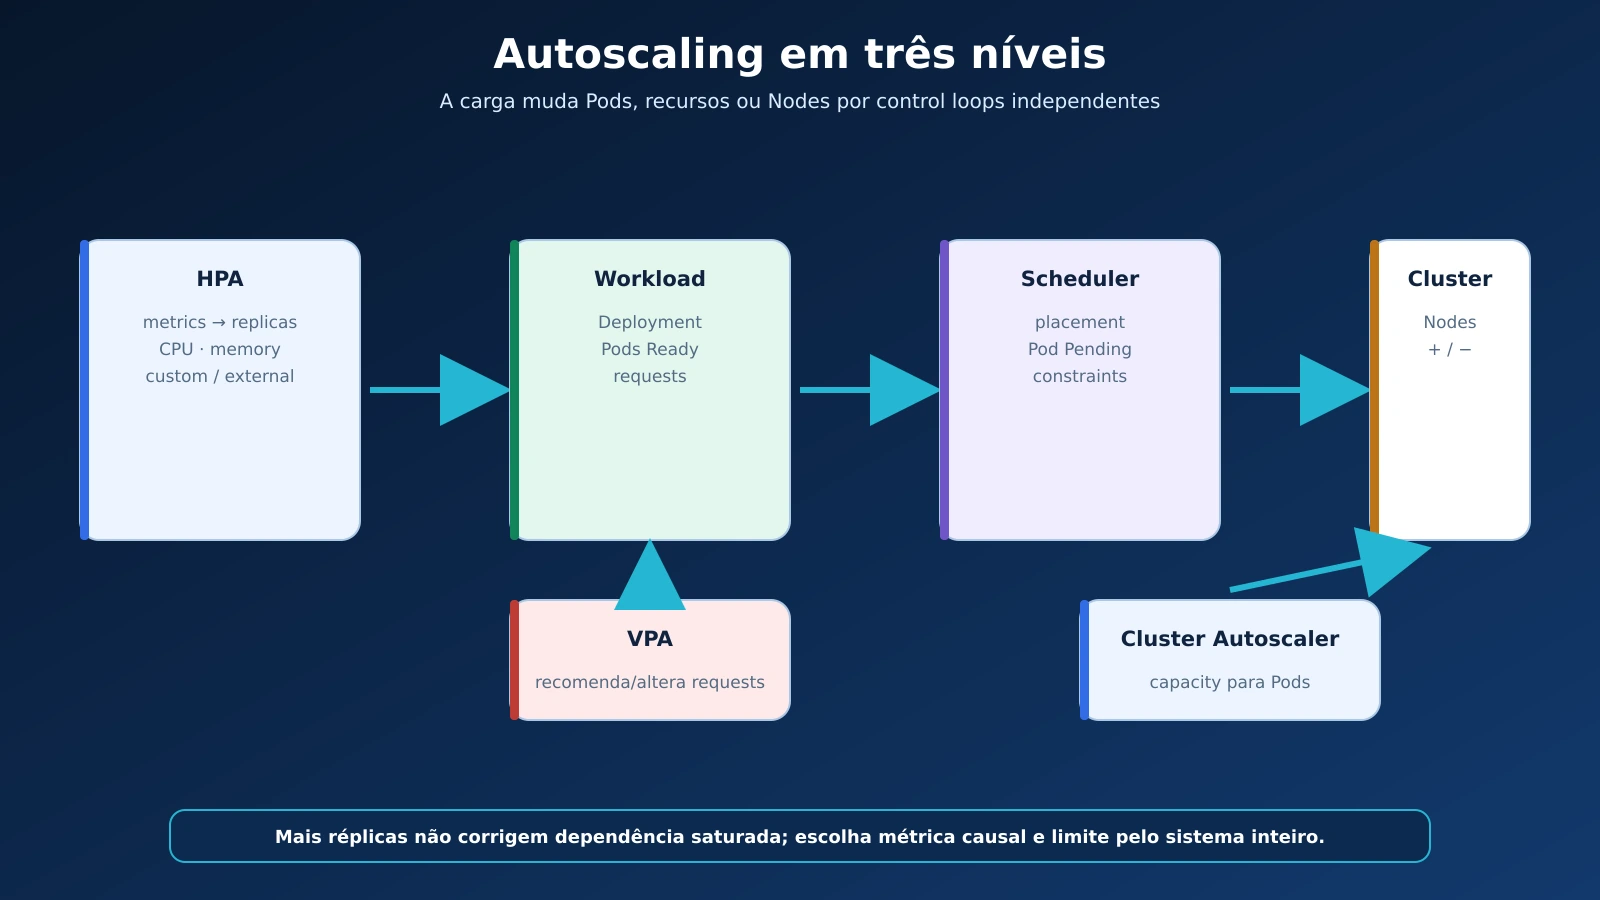
Figura 13 — HPA, VPA e Cluster Autoscaler atuando em níveis diferentes do sistema.
| Autoscaler | Altera | Sinal típico | Limite |
|---|---|---|---|
| HPA | número de Pods | CPU, memória, custom/external metric | não cria Node |
| VPA | requests/limits | histórico de uso | pode exigir restart |
| Cluster Autoscaler | número de Nodes | Pods sem placement | não acelera aplicação |
HPA atualiza a escala de workloads como Deployment ou StatefulSet conforme métricas [26]. Horizontal scaling adiciona réplicas; vertical scaling altera recursos de cada réplica.
17.2 Fórmula conceitual do HPA
Uma aproximação documentada para o número desejado é:
onde R_d é o número desejado de réplicas, R_a é o número atual, M_a é a métrica atual e M_t é a meta. Com 4 réplicas em 80% para meta de 50%, o resultado aproximado é 7 réplicas.
O controller inclui tolerância, Pods ausentes, readiness e stabilization windows. A fórmula não deve ser usada como simulador completo.
17.3 Métrica certa
CPU funciona quando demanda se correlaciona com CPU. Para worker de fila, backlog por worker ou idade da mensagem pode representar melhor o risco. Para API limitada por banco, aumentar Pods pode esgotar connections e piorar latência.
17.4 Requests e HPA
HPA por utilização de CPU precisa de requests coerentes. Sem request, a utilização relativa pode ficar indefinida para containers relevantes. Rightsizing e autoscaling são partes do mesmo sistema.
17.5 Oscilação e atraso
Autoscaling reage depois que a métrica muda. Considere:
- scrape e aggregation delay;
- tempo de decisão do controller;
- provisioning de Node;
- pull da image;
- startup e readiness;
- aquecimento de cache;
- stabilization de scale-down.
Capacidade mínima deve absorver carga durante essa soma de atrasos.
17.6 Scale to zero
Kubernetes v1.37 introduziu suporte Beta para HPA escalar workloads a zero em condições específicas com object ou external metrics [2]. Não trate Beta como universal: confirme feature gate, API, adapter e comportamento da versão instalada.
17.7 Load test e failure test
Teste subida, descida, pico, falha de Node e indisponibilidade do metrics provider. Um HPA bem configurado em steady state pode falhar quando a telemetry desaparece.
Exercícios
- Calcule
R_dpara 3 réplicas, métrica 90 e meta 60. - Escolha métrica para API, worker de fila e processamento batch.
- Trace o atraso total do pico até um novo Pod ficar Ready.
Nota Zettelkasten — ZK-K8S-017
Título: Autoscaling é control loop atrasado
Autoscaler reage a sinais com atraso e limites; capacity mínima, métrica causal, requests e dependências determinam se novas réplicas ajudam.
Capítulo 18 — Deployment patterns, Helm, Kustomize e GitOps
18.1 Estratégias de release
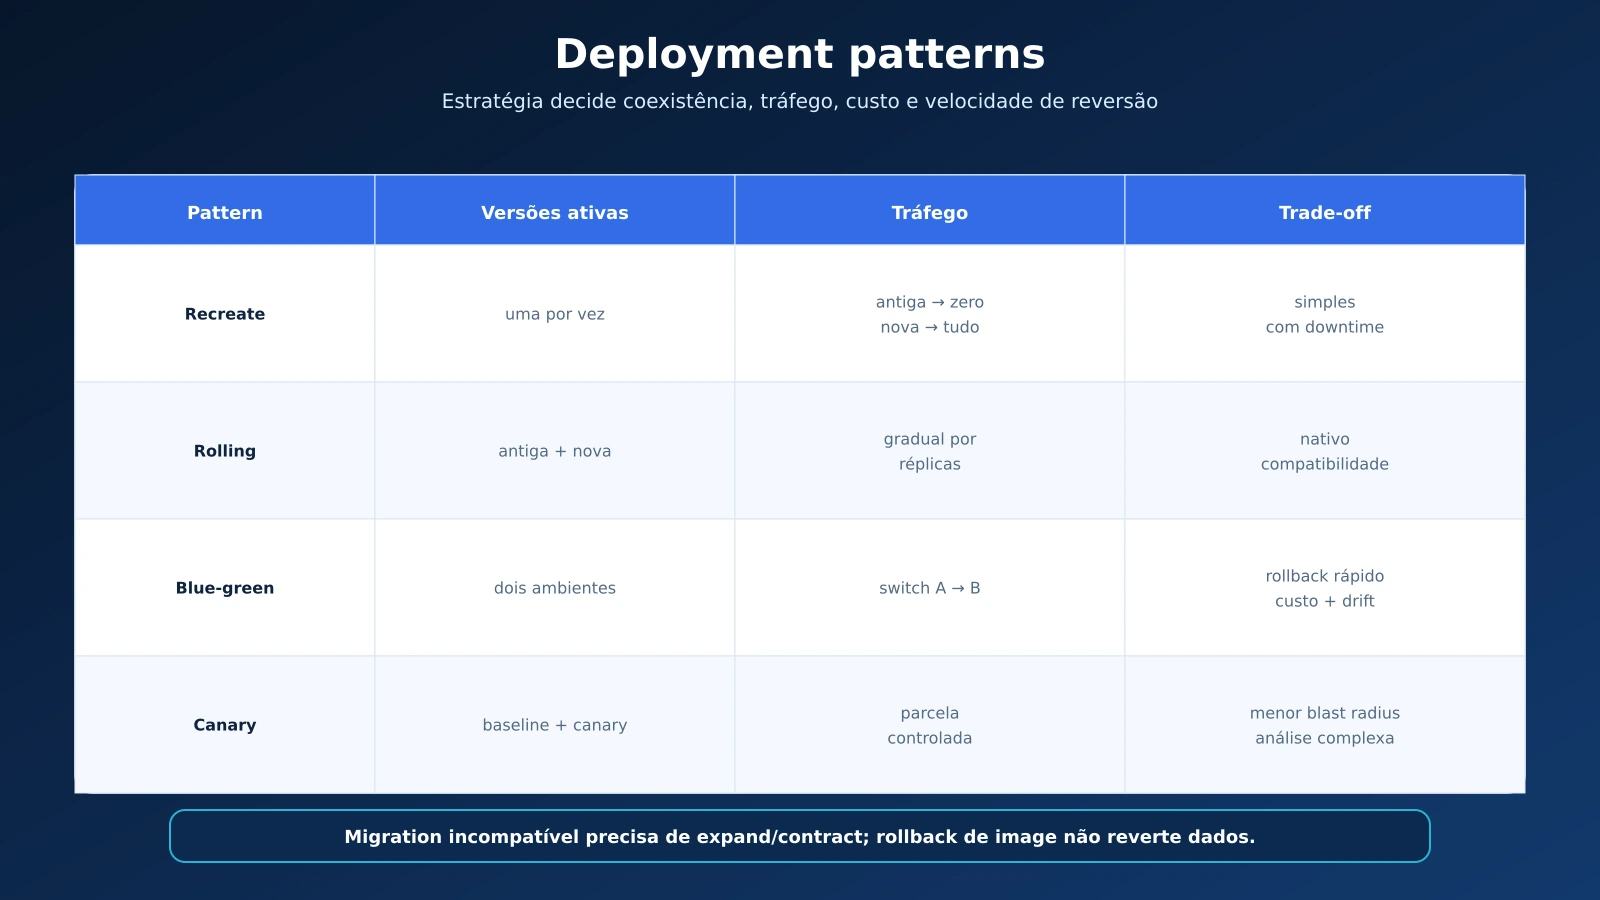
Figura 14 — Comparação entre Recreate, Rolling Update, Blue-green e Canary.
| Estratégia | Mecanismo | Vantagem | Risco |
|---|---|---|---|
| Recreate | encerra versão antiga antes da nova | simples | indisponibilidade |
| Rolling update | troca Pods gradualmente | recurso nativo do Deployment | versões coexistem |
| Blue-green | dois ambientes, troca de tráfego | rollback rápido | custo e drift |
| Canary | nova versão recebe parcela do tráfego | reduz blast radius | análise e roteamento complexos |
Nenhuma estratégia resolve migration incompatível. Use expand/contract: adicionar estrutura compatível, migrar leitores/escritores, validar, depois remover legado.
18.2 CI e CD
CI deve produzir image uma vez, testar, escanear, assinar e publicar por digest. CD promove o mesmo digest entre ambientes. Rebuild por ambiente cria artefatos diferentes e enfraquece evidência.
Pipeline mínimo:
- lint e unit tests;
- build reproduzível;
- dependency/image scan;
- SBOM e provenance;
- assinatura;
- integration tests;
- atualização declarativa do ambiente;
- policy e admission;
- rollout monitorado;
- verificação e rollback/roll-forward.
18.3 Helm
Helm empacota manifests como charts e aplica templates [29]. É adequado para distribuir aplicação parametrizável. Complexidade excessiva em templates transforma YAML em linguagem de programação difícil de testar.
Mantenha values com schema, defaults seguros e documentação. Renderize antes:
helm lint ./chart
helm template portal ./chart -f values-homolog.yaml > rendered.yaml
kubectl apply --server-side --dry-run=server -f rendered.yaml
18.4 Kustomize
Kustomize compõe base e overlays por patches, sem template textual tradicional. É útil quando os ambientes compartilham manifests estruturais e variam poucos campos.
kubectl kustomize overlays/producao
Helm e Kustomize podem coexistir, mas cada camada adicional precisa de ownership e teste do output final.
18.5 GitOps
GitOps usa Git como fonte declarativa e um controller no cluster para reconciliar o estado. Os princípios OpenGitOps enfatizam declaração, versionamento, pull automático e reconciliação contínua [30]. O fluxo deve considerar:
- proteção de branch e review;
- assinatura e origem do artefato;
- secret management;
- drift detection;
- ordem e dependências;
- rollback versus roll-forward;
- credencial do controller;
- observação de health, não apenas sync.
Synced significa que o estado desejado foi aplicado; não significa que a aplicação atende seu SLO.
18.6 Canary orientado por métricas
Compare versão canary e baseline por error rate, latency e métricas de negócio. Volume insuficiente produz falsa confiança. Defina janela, threshold e ação antes do release.
Exercícios
- Escolha estratégia para API compatível e migration incompatível.
- Compare Helm e Kustomize em um produto interno.
- Explique por que Git revert não reverte efeito externo ou dados.
Nota Zettelkasten — ZK-K8S-018
Título: Release separa artefato e configuração
CI produz artefato imutável; CD promove referência declarativa; rollout e análise decidem se o novo estado pode continuar.
Capítulo 19 — CRDs, controllers e Operator pattern
19.1 Estender a API
CustomResourceDefinition adiciona um novo tipo à Kubernetes API. Um custom resource sozinho armazena dados. Um controller transforma o objeto em API declarativa ao reconciliar desired state [27].
19.2 Operator pattern
Operator combina custom resources, controller e conhecimento operacional de um domínio. Exemplo: um PostgresCluster declara replicas, backup e versão; o Operator gerencia StatefulSets, Services, failover e status.
Isso não torna o Operator correto por definição. Ele vira parte do control plane da aplicação e precisa de:
- reconciliação idempotente;
- status e conditions úteis;
- retry com backoff;
- finalizers seguros;
- upgrade de CRD e dados;
- RBAC mínimo;
- métricas, logs e alertas;
- testes de falha;
- política de suporte.
19.3 spec e status de um CRD
apiVersion: platform.example.com/v1
kind: PortalEnvironment
metadata:
  name: homologacao
spec:
  image: registry.example.com/portal:1.4.2
  replicas: 2
status:
  observedGeneration: 7
  conditions:
    - type: Ready
      status: "True"
Schema OpenAPI deve validar campos. Versionamento exige conversion e compatibilidade. Remover campo sem migration pode deixar objetos persistidos que o controller novo não interpreta.
19.4 Quando não criar CRD
Prefira API standalone quando o domínio não é declarativo, não se encaixa em scope de cluster/namespace, exige transações complexas ou não precisa de kubectl. Usar Kubernetes como banco genérico aumenta carga no API server e etcd.
19.5 Admission webhooks
Validating admission rejeita objetos; mutating admission altera requests. Webhook lento ou indisponível pode bloquear deployments. Defina timeout, failure policy, namespace selector, availability e observability. Mutação invisível dificulta entender o manifesto final.
19.6 Custom scheduler e extender
Scheduler customizado só é justificável quando plugins e configurações nativas não atendem. Ele assume responsabilidade por placement correto. Um Pod indica schedulerName; se o scheduler correspondente não funciona, permanece Pending.
Exercícios
- Diferencie CRD, controller e Operator.
- Escolha entre CRD e API standalone para três domínios.
- Modele conditions úteis para uma reconciliação parcialmente falha.
Nota Zettelkasten — ZK-K8S-019
Título: Operator codifica operação como control loop
Operator transforma conhecimento operacional em reconciliação contínua; por isso, seus erros têm alcance semelhante ao de componentes de plataforma.
Capítulo 20 — Operação de clusters, upgrades e disaster recovery
20.1 Managed versus self-managed
Escolher serviço managed terceiriza parte do control plane, não a responsabilidade por workloads, IAM, network, data, cost e incidentes. Self-managed exige domínio de Linux, PKI, etcd, load balancing, CNI, CSI, upgrades e hardening.
20.2 High availability
Um control plane HA normalmente usa múltiplas instâncias de API server atrás de load balancer e quorum de etcd. Em kubeadm, topologias stacked e external etcd apresentam trade-offs de custo, isolamento e operação [28].
Alta disponibilidade precisa atravessar failure domains. Três control-plane Nodes no mesmo host físico não toleram perda do host.
20.3 Upgrade
Plano de upgrade deve incluir:
- support window das versões;
- release notes, deprecations e API removals;
- compatibilidade de CNI, CSI, Ingress/Gateway, metrics e Operators;
- backup e restore testado;
- canary de Node pool;
- PodDisruptionBudgets e capacity para drain;
- control plane antes/segundo regra da distribuição;
- validação funcional e observability;
- rollback suportado ou roll-forward;
- comunicação e change record.
Nunca presuma que downgrade de etcd ou control plane será simples. Teste o procedimento específico do provider/distribuição.
20.4 Backup do cluster
Separe:
- estado da Kubernetes API em
etcd; - manifests e policies em Git;
- Secrets ou referências em secret manager;
- PVs e bancos com consistência própria;
- recursos externos criados por controllers;
- imagens no registry;
- configuração de DNS, IAM e network.
Disaster recovery precisa reconstruir relações, não apenas arquivos.
20.5 Multi-cluster
Multi-cluster pode oferecer isolamento, residency, failure domain e autonomia. Também multiplica upgrades, policy, observability, identity e custo. Não use múltiplos clusters apenas para simular namespaces mais fortes sem analisar o modelo de ameaça.
20.6 Capacity e custo
O custo total inclui compute, storage, egress, load balancers, observability, licenças, control plane e trabalho operacional.
onde C_t é custo total, C_c é compute, C_s é storage, C_n é network, C_o é observability/operação e C_p é plataforma e pessoas.
Otimizar apenas CPU pode aumentar latência, incidentes e tempo humano.
20.7 Runbooks essenciais
- API server indisponível;
etcdsem quorum;- NodeNotReady em massa;
- registry indisponível;
- DNS degradado;
- CNI ou CSI com falha;
- certificate expiration;
- esgotamento de IP, PID, inode, CPU, memória ou disco;
- restore de banco e de
etcd; - revogação de credencial comprometida.
20.8 Critério de maturidade
Uma plataforma madura consegue responder:
- quem é owner de cada workload e controller?
- qual versão e API estão em uso?
- qual SLO e error budget?
- quais permissions cada identidade possui?
- qual capacity resta após perder um Node ou zona?
- quando o último restore foi testado?
- como detectar e reverter uma mudança?
- qual risco permanece aceito?
Exercícios
- Construa uma matriz managed versus self-managed para sua equipe.
- Escreva um plano de upgrade com canary de Node pool.
- Diferencie backup de
etcd, manifests e dados da aplicação.
Nota Zettelkasten — ZK-K8S-020
Título: Cluster é um produto operacional
Operar Kubernetes significa manter lifecycle, segurança, capacity, recovery e experiência de desenvolvimento; instalar Nodes é apenas o início.
Estudo de Caso Integrador — Portal Flask corporativo no Kubernetes
Este laboratório aplica os conceitos a um portal corporativo com API Flask, PostgreSQL, Redis, workers RQ e integrações externas com GLPI e Slack. O desenho é exemplo técnico; hostnames, imagens, credenciais e sizing precisam ser adaptados.
1. Requisitos
- três réplicas da API durante produção;
- workers escaláveis por backlog;
- PostgreSQL com backup e restore testado;
- Redis para fila, não como fonte única de dados críticos;
- acesso externo HTTPS;
- GLPI e Slack acessíveis apenas pelos workers autorizados;
- nenhum secret no Git ou na image;
- zero downtime para updates compatíveis;
- logs correlacionados e metrics de API/fila;
- RPO de 15 minutos e RTO de 2 horas para dados do portal.
2. Arquitetura
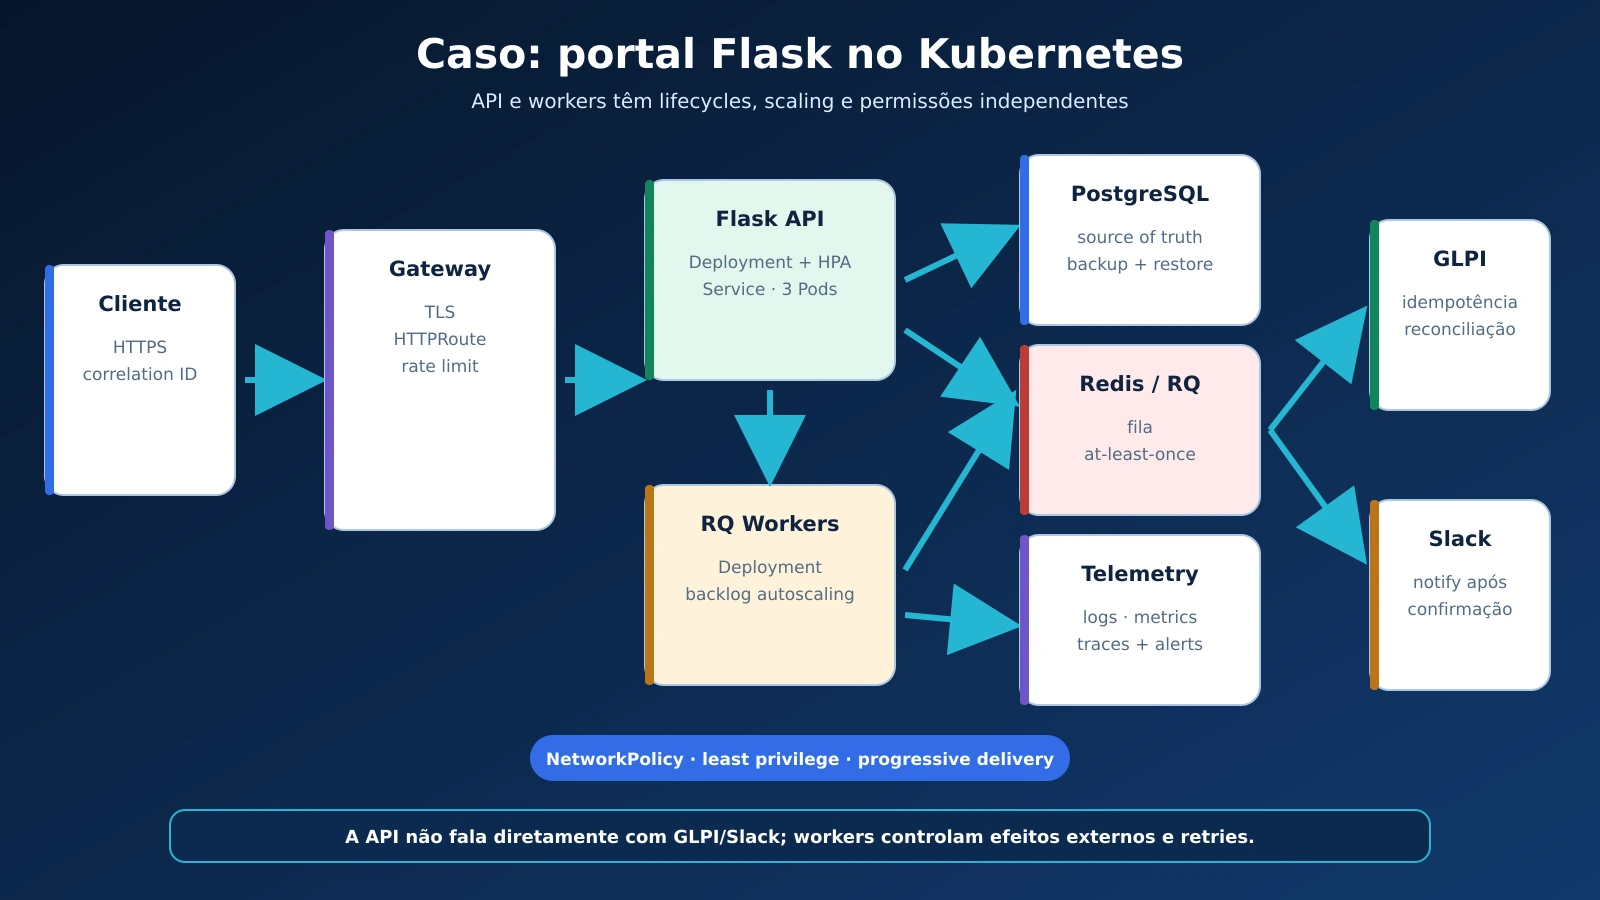
Figura 15 — Arquitetura do laboratório Flask com workers RQ, PostgreSQL, Redis, GLPI, Slack e telemetry.
| Componente | Workload | Storage | Scaling |
|---|---|---|---|
| Gateway controller | gerenciado pela plataforma | configuração declarativa | conforme implementação |
| Flask API | Deployment | stateless | HPA por CPU e latency protegida |
| RQ worker | Deployment | stateless, jobs idempotentes | métrica de backlog |
| scheduler | Deployment com 1 réplica ou controller específico | estado fora do processo | sem HPA |
| Redis | serviço managed ou StatefulSet/Operator | conforme criticidade | vertical/cluster específico |
| PostgreSQL | preferencialmente managed ou Operator maduro | volumes + backup | sem HPA genérico |
3. Namespaces e ownership
Use namespaces por boundary operacional, não um namespace por arquivo:
platform-system   Gateway, observability e policies da plataforma
portal-prod       API, workers, Services, HPA e PDB
data-prod         recursos de dados quando operados no cluster
Separar namespaces permite RBAC, quotas e NetworkPolicies distintas. Não autorize a equipe da aplicação a alterar GatewayClass ou componentes do control plane.
4. Deployment da API
apiVersion: apps/v1
kind: Deployment
metadata:
  name: portal-api
  namespace: portal-prod
  labels:
    app.kubernetes.io/name: portal
    app.kubernetes.io/component: api
spec:
  replicas: 3
  strategy:
    rollingUpdate:
      maxUnavailable: 0
      maxSurge: 1
  selector:
    matchLabels:
      app.kubernetes.io/name: portal
      app.kubernetes.io/component: api
  template:
    metadata:
      labels:
        app.kubernetes.io/name: portal
        app.kubernetes.io/component: api
    spec:
      serviceAccountName: portal-api
      automountServiceAccountToken: false
      terminationGracePeriodSeconds: 40
      securityContext:
        runAsNonRoot: true
        seccompProfile:
          type: RuntimeDefault
      containers:
        - name: api
          image: registry.example.com/portal@sha256:SUBSTITUIR_DIGEST
          ports:
            - name: http
              containerPort: 8000
          envFrom:
            - configMapRef:
                name: portal-config
          env:
            - name: DATABASE_URL
              valueFrom:
                secretKeyRef:
                  name: portal-runtime
                  key: database-url
          resources:
            requests:
              cpu: 250m
              memory: 256Mi
            limits:
              cpu: "1"
              memory: 512Mi
          startupProbe:
            httpGet: {path: /health/startup, port: http}
            periodSeconds: 2
            failureThreshold: 30
          readinessProbe:
            httpGet: {path: /health/ready, port: http}
            periodSeconds: 5
            failureThreshold: 2
          livenessProbe:
            httpGet: {path: /health/live, port: http}
            periodSeconds: 10
            failureThreshold: 3
          securityContext:
            allowPrivilegeEscalation: false
            readOnlyRootFilesystem: true
            capabilities:
              drop: ["ALL"]
          volumeMounts:
            - name: tmp
              mountPath: /tmp
      volumes:
        - name: tmp
          emptyDir:
            sizeLimit: 256Mi
Pontos importantes:
- digest torna o artefato inequívoco;
automountServiceAccountToken: falsereduz credencial desnecessária;- root filesystem read-only exige volume para
/tmp; - probes possuem semânticas distintas;
- requests sustentam scheduling e HPA;
maxSurge: 1requer capacity adicional;DATABASE_URLvem de Secret, mas a forma de criar e rotacionar o Secret ainda precisa ser definida.
5. Service e HTTPRoute
apiVersion: v1
kind: Service
metadata:
  name: portal-api
  namespace: portal-prod
spec:
  selector:
    app.kubernetes.io/name: portal
    app.kubernetes.io/component: api
  ports:
    - name: http
      port: 80
      targetPort: http
---
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: portal
  namespace: portal-prod
spec:
  parentRefs:
    - name: corporate-gateway
      namespace: platform-system
  hostnames: ["portal.example.com"]
  rules:
    - matches:
        - path:
            type: PathPrefix
            value: /
      backendRefs:
        - name: portal-api
          port: 80
O Gateway precisa permitir a route do namespace. Accepted=True não prova backend saudável; examine também ResolvedRefs, Service, EndpointSlices e readiness.
6. Workers e semântica de fila
Workers devem usar Deployment separado para atualizar e escalar sem afetar API. RQ implementa entrega que pode repetir job; integração GLPI precisa de idempotência e reconciliação.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: portal-worker
  namespace: portal-prod
spec:
  replicas: 2
  selector:
    matchLabels:
      app.kubernetes.io/name: portal
      app.kubernetes.io/component: worker
  template:
    metadata:
      labels:
        app.kubernetes.io/name: portal
        app.kubernetes.io/component: worker
    spec:
      automountServiceAccountToken: false
      terminationGracePeriodSeconds: 90
      containers:
        - name: worker
          image: registry.example.com/portal@sha256:SUBSTITUIR_DIGEST
          command: ["rq", "worker", "default"]
          resources:
            requests: {cpu: 200m, memory: 256Mi}
            limits: {cpu: "1", memory: 768Mi}
          securityContext:
            allowPrivilegeEscalation: false
            capabilities: {drop: ["ALL"]}
O worker precisa interceptar SIGTERM, parar de buscar novo job e dar destino conhecido ao job em andamento. A duração máxima precisa caber no grace period ou permitir checkpoint/retry idempotente.
7. Migrations
Não coloque migration concorrente no startup de todas as réplicas. Opções:
- Job versionado antes do rollout;
- ferramenta de release com etapa única e lock;
- Operator da aplicação;
- migration administrada fora do cluster.
Use expand/contract. Exemplo:
- adicionar coluna nullable;
- deploy que escreve formato antigo e novo;
- backfill observável;
- deploy que lê novo formato;
- tornar constraint obrigatória;
- remover campo antigo em release posterior.
Rollback da API continua possível durante a janela de compatibilidade.
8. Security e network
Policies mínimas:
- Gateway → API na porta 8000;
- API → PostgreSQL e Redis;
- worker → PostgreSQL, Redis, GLPI, Slack e telemetry;
- DNS para workloads permitidos;
- nenhuma entrada direta no worker;
- default-deny para ingress e egress.
Como GLPI e Slack são endpoints externos, a allowlist pode exigir egress gateway, proxy ou controle por FQDN da solução de rede. IPs externos mutáveis tornam policy por CIDR frágil.
RBAC da API e do worker pode ser vazio se não chamam Kubernetes API. CI/CD e GitOps controller possuem identidades separadas. Acesso humano a pods/exec, Secrets e port-forward deve ser explícito e auditado.
9. Availability e disruptions
PDB da API:
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: portal-api
  namespace: portal-prod
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app.kubernetes.io/name: portal
      app.kubernetes.io/component: api
Adicione topology spread entre Nodes e, se houver infraestrutura multi-zone, entre zonas. Teste perda de uma réplica, drain de Node e falha de zona. O banco e Redis podem continuar como single points mesmo que a API tenha três Pods.
10. Autoscaling
API pode usar HPA por CPU como primeiro sinal, observando conexões do banco e latency. Worker deve preferir backlog e idade da mensagem por réplica. Antes de escalar:
- meça tempo médio e p95 do job;
- imponha limites de concorrência nas APIs externas;
- defina retry budget;
- garanta idempotência;
- limite máximo de réplicas conforme connections e rate limits.
Escalar worker para 100 réplicas contra GLPI com limite de 10 requests/s apenas transforma fila interna em throttling externo.
11. Observability
Dashboard mínimo:
| Camada | Métricas/sinais |
|---|---|
| Gateway | rate, 4xx/5xx, TLS, latency |
| API | request rate, error rate, p50/p95/p99, pool do banco |
| worker | backlog, oldest-job age, duração, retries, failures |
| Redis | memory, evictions, connections, persistence |
| PostgreSQL | connections, locks, replication lag, disk, slow queries |
| Kubernetes | desired/available replicas, restarts, OOM, Pending, Node pressure |
| integrações | rate limit, timeout, status e circuit breaker |
Logs compartilham correlation_id; traces ligam Gateway, API, banco e enqueue. Job carrega o identificador para o worker. Alertas devem se apoiar em impacto/SLO, não apenas em CPU alta.
12. Backup e disaster recovery
- PostgreSQL: backup consistente, WAL quando aplicável e restore periódico;
- Redis: definir se é cache/fila reconstruível ou estado que precisa persistir;
- manifests: Git protegido e replicado;
- Secrets: backup/restore do secret manager e referências;
- volumes: snapshot mais cópia independente;
- cluster: procedimento de reconstrução;
- integrações: reconciliation para efeitos remotos ambíguos.
O teste final é restaurar em ambiente isolado e comprovar RPO/RTO, não verificar apenas se o arquivo de backup existe.
13. Pipeline e entrega
- commit revisado;
- testes de código e integração;
- image build, scan, SBOM, assinatura e digest;
- manifests renderizados e validados;
- policy checks;
- deploy em homologação;
- testes funcionais e de falha;
- promoção do mesmo digest;
- canary/rolling update;
- análise de metrics e decisão de continuar ou reverter.
14. Evidência de conclusão
Uma entrega deve responder:
- qual digest foi implantado?
- qual commit e quais manifests produziram o estado?
- quais conditions confirmam o rollout?
- quantos endpoints estão Ready?
- quais testes e policy checks passaram?
- qual migration ocorreu e como é revertida?
- quais dashboards e alertas foram observados?
- qual risco residual foi aceito?
Apêndice A — Templates reutilizáveis
A.1 Checklist de manifesto de workload
- [ ] image imutável por versão ou digest;
- [ ] labels e selectors coerentes;
- [ ] requests e limits fundamentados;
- [ ] startup, readiness e liveness com semântica;
- [ ] graceful shutdown e grace period;
- [ ] execução non-root e capabilities mínimas;
- [ ] ServiceAccount exclusiva ou token desabilitado;
- [ ] configuração separada de secrets;
- [ ] logs estruturados em
stdout/stderr; - [ ] topology e PDB compatíveis;
- [ ] rollout e rollback definidos;
- [ ] owner, SLO, runbook e dashboard registrados.
A.2 Template de Namespace com limites
apiVersion: v1
kind: Namespace
metadata:
  name: equipe-exemplo
  labels:
    pod-security.kubernetes.io/enforce: restricted
    pod-security.kubernetes.io/audit: restricted
    pod-security.kubernetes.io/warn: restricted
---
apiVersion: v1
kind: ResourceQuota
metadata:
  name: compute
  namespace: equipe-exemplo
spec:
  hard:
    requests.cpu: "4"
    requests.memory: 8Gi
    limits.cpu: "8"
    limits.memory: 16Gi
    pods: "30"
---
apiVersion: v1
kind: LimitRange
metadata:
  name: defaults
  namespace: equipe-exemplo
spec:
  limits:
    - type: Container
      defaultRequest:
        cpu: 100m
        memory: 128Mi
      default:
        cpu: 500m
        memory: 512Mi
Defaults evitam ausência total, mas não substituem rightsizing por workload.
A.3 Template de change plan
Objetivo e comportamento esperado:
Versão atual → versão alvo:
APIs, CRDs e add-ons afetados:
Capacity necessária durante rollout:
Migration de dados:
PDB e drain:
Validações antes/durante/depois:
Critérios de abortar:
Rollback ou roll-forward:
Owner e janela:
Riscos residuais:
A.4 Template de incidente
Sintoma e impacto:
Início e detecção:
Clusters/namespaces/workloads afetados:
Mudanças recentes:
Estado de API, Nodes, Pods e endpoints:
Events, logs, metrics e traces:
Hipóteses e evidências:
Contenção aplicada:
Risco da contenção:
Próxima decisão e responsável:
```---
# Apêndice B — `kubectl` cheat sheet orientado a diagnóstico

Confirme context e namespace antes de qualquer comando. Comandos abaixo são de leitura, salvo quando indicado.

## B.1 Identidade e contexto

| Objetivo | Comando |
|---|---|
| context ativo | `kubectl config current-context` |
| todos os contexts | `kubectl config get-contexts` |
| trocar context | `kubectl config use-context NOME` |
| verificar autorização | `kubectl auth can-i get secrets -n NAMESPACE` |
| versões | `kubectl version` |

## B.2 Estado de workloads
```bash
kubectl get deploy,rs,pod -n NAMESPACE -o wide
kubectl describe pod POD -n NAMESPACE
kubectl get events -n NAMESPACE --sort-by=.metadata.creationTimestamp
kubectl logs POD -n NAMESPACE -c CONTAINER --since=30m
kubectl logs POD -n NAMESPACE -c CONTAINER --previous
kubectl rollout status deployment/APP -n NAMESPACE
kubectl rollout history deployment/APP -n NAMESPACE
B.3 Networking
kubectl get svc,endpointslice -n NAMESPACE
kubectl get networkpolicy -A
kubectl get gateway,httproute -A
kubectl describe httproute ROUTE -n NAMESPACE
kubectl port-forward -n NAMESPACE service/APP 8080:80
B.4 Resources e scheduling
kubectl top nodes
kubectl top pods -n NAMESPACE --containers
kubectl describe node NODE
kubectl get resourcequota,limitrange -n NAMESPACE
kubectl get pod POD -n NAMESPACE -o jsonpath='{.spec.nodeName}'
B.5 Storage
kubectl get storageclass
kubectl get pv
kubectl get pvc -n NAMESPACE
kubectl describe pvc CLAIM -n NAMESPACE
kubectl get volumesnapshot -A
B.6 Mudanças com cautela
| Ação | Comando | Risco |
|---|---|---|
| reiniciar rollout | kubectl rollout restart deployment/APP -n NS |
mascara causa e troca todos os Pods |
| reverter | kubectl rollout undo deployment/APP -n NS |
não reverte dados/efeitos externos |
| drenar Node | kubectl drain NODE --ignore-daemonsets |
pode bloquear em PDB ou indisponibilizar workload |
| remover objeto | kubectl delete -f arquivo.yaml |
finalizers, PV e recursos externos |
| escalar manualmente | kubectl scale deployment/APP --replicas=4 -n NS |
GitOps/HPA pode desfazer a mudança |
Use --dry-run=server quando aplicável e revise o diff:
bash
kubectl diff -f manifests/
kubectl apply --server-side --dry-run=server -f manifests/
—
Apêndice C — Matrizes de decisão
C.1 Workload
| Pergunta | Escolha provável |
|---|---|
| réplicas intercambiáveis e serviço contínuo? | Deployment |
| identidade/volume estável por réplica? | StatefulSet |
| uma instância por Node? | DaemonSet |
| termina após completar? | Job |
| repete em agenda? | CronJob |
| apenas investigação temporária? | Pod isolado |
C.2 Exposição
| Necessidade | Escolha provável |
|---|---|
| acesso estável interno | ClusterIP Service |
| discovery direto de Pods | headless Service |
| uma porta L4 externa | LoadBalancer Service |
| compatibilidade HTTP existente | Ingress + controller |
| ownership e roteamento avançado | Gateway API |
C.3 Configuração e dados
| Dado | Mecanismo | Observação |
|---|---|---|
| configuração não sensível pequena | ConfigMap | limite e reload |
| credencial | Secret + encryption/RBAC | base64 não é proteção |
| secret corporativo | external secret manager | identity, rotation e outage |
| arquivo efêmero | emptyDir |
desaparece com Pod |
| dado persistente | PVC/serviço de dados | backup e restore |
| metadata do Pod | Downward API | evita duplicação manual |
C.4 Scaling
| Gargalo | Resposta possível | Verificação |
|---|---|---|
| CPU por réplica | HPA | request e CPU correlacionam com demanda? |
| backlog | HPA/custom autoscaler | métrica mede idade e volume? |
| request inadequado | VPA/rightsizing | restart e limite são aceitáveis? |
| Pods sem Node | Cluster Autoscaler | novo Node resolve constraints? |
| banco saturado | otimizar/limitar dependência | mais Pods podem piorar |
Apêndice D — Antipatterns e correções
| Antipattern | Consequência | Correção |
|---|---|---|
usar latest |
rollout não reproduzível | versão imutável ou digest |
| Pod direto em produção | sem reconciliação de réplicas | controller adequado |
| banco no mesmo Pod da API | lifecycle e scaling acoplados | serviço/StatefulSet separado |
| liveness consulta dependência externa | restart storm | probe local com semântica |
| nenhuma readiness | tráfego durante startup/falha | readiness específica |
| sem requests | scheduling e HPA frágeis | medir e declarar demanda |
| limits arbitrários baixos | throttling/OOM | load test e rightsizing |
| Secret em Git | vazamento durável | secret manager e rotação |
RBAC com * |
privilege escalation | verbos e resources mínimos |
| Service sem verificar endpoints | debug no componente errado | selector, readiness e EndpointSlice |
| NetworkPolicy em CNI sem enforcement | falsa segurança | validar implementação e testes |
| três réplicas no mesmo Node | falsa HA | topology spread/anti-affinity |
| PDB impossível | drain bloqueado | compatibilizar réplicas e capacity |
| snapshot nunca restaurado | backup não comprovado | restore periódico isolado |
| migration no startup de cada Pod | corrida e rollout bloqueado | Job único + expand/contract |
kubectl edit permanente |
configuration drift | Git e reconciliation |
| restart como diagnóstico | causa perdida | Events, logs, metrics e hipótese |
GitOps Synced como health |
falha funcional não detectada | SLO, probes e análise pós-deploy |
| um cluster por moda | custo operacional multiplicado | boundary e modelo de ameaça explícitos |
Apêndice E — Active Recall e Feynman
Responda sem consultar o texto. Depois confronte a resposta com o capítulo.
- Qual problema Kubernetes resolve além de executar containers?
- Qual a diferença entre image, container e Pod?
- Como API server,
etcd, scheduler e kubelet cooperam? - O que acontece entre desired state e current state?
- Por que
status.observedGenerationimporta? - Como labels, selectors e ownerReferences relacionam objetos?
- Por que Pod
Runningpode estar indisponível? - Quando startup probe protege liveness?
- Quando usar Deployment, StatefulSet, DaemonSet ou Job?
- Por que Job exige idempotência?
- O que ConfigMap e Secret não resolvem?
- Como Service encontra Pods?
- Por que Ingress sem controller não funciona?
- Que ownership Gateway API torna explícito?
- Quais camadas formam o caminho cliente → container?
- O que NetworkPolicy controla e o que não controla?
- Por que request e uso real são medidas diferentes?
- Como QoS influencia eviction?
- Qual a diferença entre taint, toleration e affinity?
- Por que réplicas precisam de topology spread?
- O que PDB protege e o que não protege?
- Como PVC, PV, StorageClass e CSI se relacionam?
- Por que snapshot pode não ser backup suficiente?
- Como autenticação, autorização e admission diferem?
- Como criar Pod pode levar a privilege escalation?
- Qual a diferença entre Events, logs, metrics e traces?
- Como diagnosticar
CrashLoopBackOff? - Qual fórmula conceitual orienta o HPA?
- Por que mais Pods podem piorar um banco saturado?
- Como rolling, blue-green e canary diferem?
- O que GitOps reconcilia e o que
Syncednão prova? - Qual a diferença entre CRD, controller e Operator?
- O que precisa ser salvo além do
etcd? - Que responsabilidades permanecem em Kubernetes managed?
Técnica Feynman
Explique para uma pessoa que conhece Docker, mas nunca operou Kubernetes:
- “Kubernetes é uma API com control loops.”
- “Pod não é uma pequena VM.”
- “Service é identidade estável sobre endpoints efêmeros.”
- “Readiness controla tráfego; liveness controla reinício.”
- “Request é uma promessa usada pelo scheduler.”
- “Namespace não equivale a isolamento de máquina.”
- “Três réplicas podem continuar formando um single failure domain.”
- “Backup só existe quando restore foi demonstrado.”
Inclua em cada explicação um exemplo, um contraexemplo e uma falha operacional.
Apêndice F — Projeto prático e rubric
F.1 Projeto
Implante em cluster de laboratório uma API Flask, um worker e dependências falsas. Entregue:
- Dockerfile non-root e image versionada;
- Namespace, quotas e Pod Security;
- Deployments separados para API e worker;
- probes e graceful shutdown;
- ConfigMap e referência a Secret sem valor no Git;
- Services e Gateway/Ingress local;
- default-deny e allowlists de network;
- requests, limits, HPA e topology spread;
- PDB e teste de drain;
- dashboards, logs correlacionados e alerts;
- rolling update e rollback;
- backup e restore de dado de laboratório;
- runbook de três falhas;
- relatório com limitações e evidências.
F.2 Fault injection
Simule com segurança:
- processo travado;
- readiness falhando;
- image inexistente;
- Secret ausente;
- selector incorreto;
- DNS ou egress bloqueado;
- limite de memória excedido;
- Node drenado;
- metrics provider indisponível;
- timeout ambíguo no fake GLPI.
F.3 Rubric
| Dimensão | Insuficiente | Adequado | Excelente |
|---|---|---|---|
| arquitetura | objetos sem relação | fluxos identificados | boundaries e failure modes explícitos |
| workload | Pod direto | controllers corretos | lifecycle e idempotência tratados |
| health | uma probe genérica | probes separadas | semântica e failure test |
| recursos | defaults arbitrários | requests medidos | capacity e rightsizing contínuo |
| network | acesso amplo | Services e policies | fluxo testado por camada |
| security | privilégios default | RBAC e Pod Security | supply chain e auditoria |
| storage | volume criado | backup definido | restore cumpre RPO/RTO |
| observability | apenas logs | metrics e alerts | correlação por SLO e traces |
| entrega | apply manual | pipeline declarativo | artefato assinado e progressive delivery |
| operação | sem runbook | incidentes básicos | upgrades e DR exercitados |
Pontue de 0 a 2 por dimensão. Violação crítica de segurança, perda de dados ou ausência de restore impede classificação “Excelente” mesmo com nota numérica alta.
Apêndice G — Glossário
| Termo | Explicação em português |
|---|---|
| Admission | etapa que valida ou modifica uma requisição à API |
| CNI | interface para plugins de network de containers |
| CSI | interface para plugins de storage |
| CRD | definição de um novo tipo na Kubernetes API |
| Control plane | componentes que mantêm estado e decisões globais |
| Controller | processo que reconcilia estado desejado e atual |
| Data plane | Nodes e mecanismos que executam e encaminham workloads |
| Desired state | estado declarado em spec |
| EndpointSlice | conjunto escalável de endpoints de um Service |
| Eviction | término de Pod provocado por pressão, manutenção ou policy |
| Failure domain | conjunto de recursos que pode falhar em conjunto |
| Finalizer | chave que adia remoção até a limpeza concluir |
| GitOps | reconciliação de estado declarativo armazenado em Git |
| HPA | autoscaler que altera número de réplicas |
| Image digest | identificador criptográfico do conteúdo da image |
| Ingress | API estável e congelada para exposição HTTP/HTTPS |
| Kubelet | agent do Node que mantém Pods locais |
| Namespace | escopo lógico para recursos namespaced |
| NetworkPolicy | regras L3/L4 de tráfego aplicadas pelo plugin compatível |
| Node | máquina registrada que executa Pods |
| Operator | controller com conhecimento operacional de um domínio |
| PDB | limite de indisponibilidade em disruptions voluntárias |
| Pod | menor unidade agendada, com um ou mais containers |
| PVC | solicitação de storage persistente |
| QoS | classificação baseada em requests e limits |
| RBAC | autorização baseada em Roles e Bindings |
| Reconciliation Loop | ciclo observar–comparar–agir de um controller |
| RPO | perda máxima de dados tolerável medida no tempo |
| RTO | tempo máximo tolerável para restauração |
| Service | identidade e acesso estáveis para conjunto de endpoints |
| ServiceAccount | identidade de workload na Kubernetes API |
| StatefulSet | controller para Pods com identidade aderente |
| Taint | marca no Node que repele Pods sem toleration |
| Workload | aplicação ou tarefa executada por Pods/controllers |
Apêndice H — Plano de revisão espaçada
| Momento | Conteúdo | Prática |
|---|---|---|
| dia 0 | capítulos 1–5 | aplicar primeiro Deployment e narrar o control loop |
| dia 1 | capítulos 6–10 | corrigir probes, Service e HTTPRoute |
| dia 3 | capítulos 11–15 | criar policies, resources e PVC |
| dia 7 | capítulos 16–20 | diagnosticar falhas, HPA e upgrade |
| dia 14 | estudo de caso | reproduzir arquitetura sem consultar o desenho |
| dia 30 | projeto prático | executar fault injection e rubric |
Na revisão, tente recuperar a resposta antes de reler. Atualize flags, API versions e feature states conforme a versão do cluster, mas preserve os modelos mentais.
Referências oficiais
- Kubernetes Documentation
- Kubernetes v1.37: Garhwal
- Kubernetes Components
- Nodes
- Deployments
- Organizing Cluster Access Using kubeconfig
- StatefulSets
- DaemonSet
- Jobs
- ConfigMaps
- Good Practices for Kubernetes Secrets
- Services, Load Balancing and Networking
- Ingress Controllers
- Gateway API
- Network Policies
- Resource Management for Pods and Containers
- Kubernetes Scheduler
- Taints and Tolerations
- Pod Topology Spread Constraints
- Pod Priority and Preemption
- Persistent Volumes
- Dynamic Volume Provisioning
- RBAC Good Practices
- Pod Security Standards
- Resource Metrics Pipeline
- HorizontalPodAutoscaler Walkthrough
- Custom Resources
- Options for Highly Available Topology
- Helm Documentation
- OpenGitOps Principles
- Security Checklist
- Application Security Checklist
- Storage Classes
- Volume Snapshots
- Scheduling, Preemption and Eviction
Encerramento
Kubernetes torna explícitas decisões que antes ficavam dispersas em scripts e máquinas: quantas réplicas devem existir, onde podem executar, como recebem tráfego, que recurso consomem, que storage montam e quais identidades podem agir. A plataforma não elimina falhas; ela oferece APIs e control loops para detectá-las, limitar seu alcance e recuperar estado.
O domínio profissional de Kubernetes não é medido pelo número de comandos memorizados. Ele aparece na capacidade de explicar por que um Pod está Pending, o que uma probe realmente significa, como um Service chega a seus endpoints, por que um retry pode duplicar um efeito e como restaurar dados depois de uma perda real.
Uma operação madura combina artefato imutável, desired state versionado, least privilege, capacity conhecida, observability correlacionada, progressive delivery e recovery testado. O resultado não é apenas um cluster funcionando hoje, mas uma plataforma que pode mudar, falhar e ser recuperada de maneira compreensível.